에이전트를 쓰다 보면 성능보다 같은 말을 또 하는 것에서 지친다.
"이 서버는 SSH 포트가 2222 다", "이 프로젝트는 탭을 쓴다", "도커에 sudo 붙이지
마라" — 어제 했던 설명을 오늘 또 한다. 모델을 더 좋은 걸로 바꿔도 이건 안
고쳐진다. 성능 문제가 아니라 세션이 끝난 뒤에 무엇이 남는가의 문제이기
때문이다.
Hermes 를 리눅스에 올리고
MCP 로 도구까지 붙였다면, 남은 이야기가
이것이다. 이 글은 Hermes 가 무엇을 어디에 기억하는지, 대화하면서 어떻게
배우는지, 그리고 관리하는 사람이 그걸 어떻게 들여다보고 되돌리는지를 다룬다.
주의
이 글은 공식 저장소의 문서를 근거로 정리한 것이고, 앞의 두 글과 마찬가지로
직접 돌려 확인하지 못했다. 글을 쓴 환경에서hermes-agent.nousresearch.com
으로 나가는 통신이 막혀 있어 설치가 안 된다. 다만 이번에는 저장소를 통째로
받아website/docs/를 직접 읽었고, 숫자와 명령은 모두 거기서 옮긴 것이다
(기준 커밋5eb99eb). 버전이 오르면 기본값은 달라질 수 있으니 각자 환경에서
hermes curator status같은 것으로 한 번 확인하고 쓰기 바란다.
기억을 네 곳에 나눠 담는다#
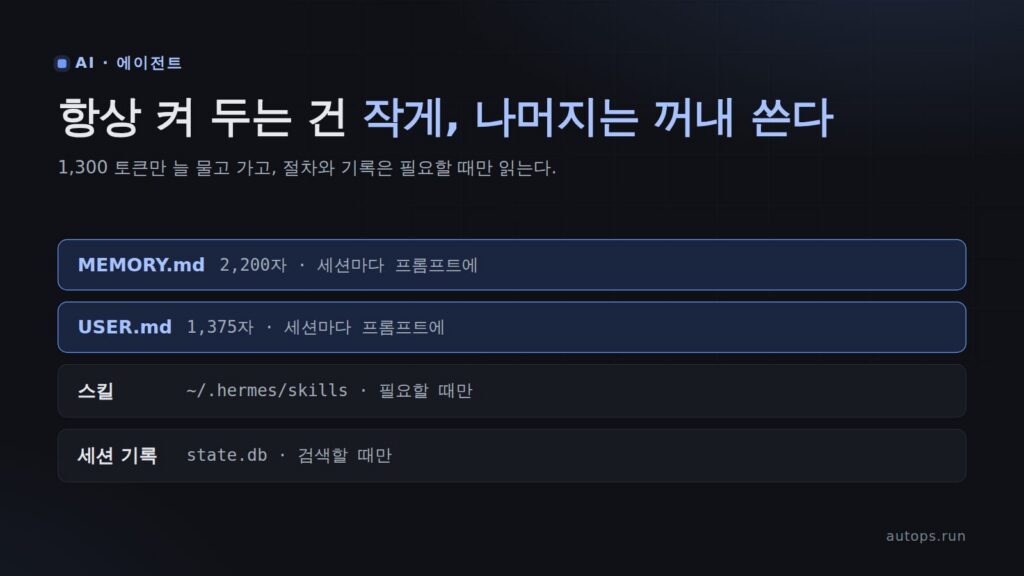
먼저 전체 그림이다. Hermes 의 기억은 한 덩어리가 아니라 성격이 다른 네 층이다.
| 층 | 무엇이 들어가나 | 어디에 | 한도 | 언제 읽히나 |
|---|---|---|---|---|
| MEMORY.md | 환경 사실, 관례, 배운 것 | ~/.hermes/memories/ |
2,200자 | 세션 시작마다 프롬프트에 |
| USER.md | 나에 대한 것 — 선호, 말투, 역할 | 같은 곳 | 1,375자 | 세션 시작마다 프롬프트에 |
| 스킬 | 절차 — "이 일은 이렇게 한다" | ~/.hermes/skills/ |
없음 | 필요할 때만 |
| 세션 기록 | 지금까지의 대화 전부 | ~/.hermes/state.db |
없음 | 검색할 때만 |
이 나눔이 이 글의 핵심이다. 항상 켜 두는 것은 작게 묶고(둘 합쳐 약 1,300 토큰),
나머지는 필요할 때만 꺼낸다. "전부 기억한다"고 광고하는 설계는 프롬프트가
무한정 길어지고, 길어진 만큼 매 턴 돈이 나간다. 한도를 둔 쪽이 운영하기에 낫다.
한도에 부딪히면 조용히 버리지 않는다#
2,200자는 생각보다 금방 찬다. 그런데 꽉 찼을 때 동작이 좋다.
{
  "success": false,
  "error": "Memory at 2,100/2,200 chars. Adding this entry (250 chars) would exceed the limit. Consolidate now: use 'replace' to merge overlapping entries into shorter ones or 'remove' stale or less important entries (see current_entries below), then retry this add — all in this turn.",
  "usage": "2,100/2,200"
}
오래된 것을 슬쩍 밀어내는 게 아니라 에러를 낸다. 에이전트가 그 자리에서
현재 항목을 보고, 겹치는 것을 합치거나 낡은 것을 지운 다음 다시 넣는다. 무엇이
사라졌는지 모르는 상태가 안 생긴다는 뜻이다.
시스템 프롬프트에는 이렇게 박힌다. 용량까지 같이 들어가서 에이전트가 스스로
"슬슬 정리할 때"를 안다.
══════════════════════════════════════════════
MEMORY (your personal notes) [67% — 1,474/2,200 chars]
══════════════════════════════════════════════
User's project is a Rust web service at ~/code/myapi using Axum + SQLx
§
This machine runs Ubuntu 22.04, has Docker and Podman installed
§
User prefers concise responses, dislikes verbose explanations참고
이 블록은 세션 시작 때 한 번 찍히고 중간에 바뀌지 않는다. 대화 도중 저장한
기억은 디스크에는 바로 들어가지만 프롬프트에는 다음 세션부터 보인다. LLM 의
프리픽스 캐시를 깨지 않으려고 일부러 그렇게 둔 것이다.
/new 를 안 하면 이 구조가 안 돈다#
여기가 실무에서 제일 많이 놓치는 자리다.
기억 장치는 전부 세션이 끝나는 순간을 기준으로 설계돼 있다. MEMORY.md 가
다음 세션으로 핵심을 넘기고, 넘기지 못한 것은 session_search 가 메운다. 반대로
한 세션 안에서는 이 기계가 돌 이유가 없다 — 필요한 건 아직 대화창에 다 있으니까.
문제는 메신저 게이트웨이다. 텔레그램·디스코드 대화는 일부러 하나의 세션으로
계속 이어진다. 재시작해도, 밤에 장비를 꺼도 이어진다. 리셋하지 않으면 채팅
하나가 몇 주짜리 세션이 된다. 편하지만 대가가 있다.
- 압축이 점점 길어진 기록 위에서 반복해서 돌아 비싸진다
- 새로 쓴 기억이 위의 이유로 그 세션에는 안 보인다
- 잊고 → 기억에서 꺼내고 → 과거를 검색하는 학습 고리가 아예 안 돈다
/new                 # 일이 끝났을 때, 주제가 바뀔 때, 하루를 시작할 때
/new deploy-fix      # 제목을 달아 두면 나중에 찾기 쉽다
CLI 는 명령 한 번이 곧 새 세션이라 저절로 되지만, 게이트웨이에서는 내가 끊어
줘야 한다. 이 습관 하나가 나머지 전부를 살린다.
대화하면서 배운다 — 알아서#
턴이 끝나면 백그라운드 리뷰가 포크로 뜬다. 방금의 대화를 되짚어서 기억으로
남길 사실과 스킬로 남길 절차를 고른다. 활성 대화는 건드리지 않는다.
기본은 메인 모델로 돈다. 이미 프롬프트 캐시가 따뜻해서 캐시 읽기 값만 든다.
그래도 비싸면 싼 모델로 내려보낸다.
auxiliary:
  background_review:
    provider: openrouter
    model: google/gemini-3-flash-preview   # auto(기본) = 메인 모델
    enabled: true                          # false = 자동 리뷰 끔
문서 기준으로 3~5배 싸진다. 다른 모델은 메인 모델의 캐시를 못 쓰므로, 전체
대화 대신 최근 턴 + 옛 부분 요약으로 된 압축본을 넘긴다. 그래도 기억 포착은
동일하고 스킬 포착도 거의 같았다고 적혀 있다.
로컬 LLM 을 쓴다면 기본값이 알아서 비켜 준다. 리뷰가 내 다음 프롬프트가 쓸 GPU 를
잡고 있으면 곤란하니, 장비가 조용해질 때까지 미뤘다가 돈다(defer: auto).
기다리기 싫으면 직접 부른다.
/refine
/refine save the deploy workflow as a skill     # 무엇을 남길지 찍어 줄 수도 있다
무엇을 저장하고 무엇을 넘기나#
| 저장한다 | 넘긴다 |
|---|---|
| 선호 — "타입스크립트를 쓴다" | 뻔한 것 — "파이썬을 물어봤다" |
| 환경 사실 — "이 서버는 Debian 12 + PostgreSQL 16" | 다시 찾으면 되는 것 — 문법, 라이브러리 사용법 |
| 교정 — "도커에 sudo 쓰지 마라" | 원본 덩어리 — 코드 블록, 로그, 표 |
| 관례 — "탭, 120자, Google 스타일 독스트링" | 한 번 쓰고 버릴 것 — 임시 경로 |
| 끝낸 일 — "2026-01-15 에 MySQL→PostgreSQL 이관" | 이미 AGENTS.md 에 있는 것 |
좋은 항목은 짧고 밀도가 높다.
좋음: 사용자 장비는 macOS 14, Homebrew, Docker Desktop + Podman. zsh + oh-my-zsh. VS Code(Vim 키).
좋음: 스테이징(10.0.1.50)은 SSH 22 가 아니라 2222. 키는 ~/.ssh/staging_ed25519.
나쁨: 사용자에게 프로젝트가 있다.
절차는 스킬로 남는다#
기억이 사실이라면 스킬은 절차다. 여러 단계짜리 작업을 한 번 풀어내면
에이전트가 skill_manage 로 그 방법을 적어 둔다. 다음부터는 그 문서를 읽고
시작한다. 이게 "성장"이라는 말에 실체를 주는 부분이다.
직접 시킬 수도 있다. /learn 은 무엇이든 가리킬 수 있다.
/learn 방금 스테이징 배포한 순서
/learn ~/projects/acme-sdk 의 REST 클라이언트, 인증과 페이지네이션 위주로
/learn https://docs.example.com/api/quickstart
/learn ~/books/designing-data-intensive-applications.pdf
마지막처럼 덩치가 큰 자료는 한 파일에 욱여넣지 않는다. 얇은 SKILL.md 에 핵심
모델과 목차만 두고, 챕터별로 references/ 아래 파일을 하나씩 만든다. 참조
파일은 읽기 전까지 토큰을 쓰지 않으니, 책 한 권을 넣어 둬도 질문 하나의 비용은
답에 비례한다. 같은 주제로 /learn 을 또 돌리면 새 스킬을 만들지 않고 기존
스킬에 접어 넣는다.
읽는 방식도 3단이다. 목록만 훑는 게 기본이고, 본문은 필요할 때만 편다.
0단계: skills_list()          → 이름·설명·분류만        (~3k 토큰)
1단계: skill_view(이름)        → 본문 전체
2단계: skill_view(이름, 경로) → 참조 파일 하나참고
스킬을 직접 만들어 보는 쪽은 Hermes 스킬 만들기에
따로 정리했다.SKILL.md형식과, 스킬을 만들어 두고도 안 불리게 만드는
description한 줄에 관한 이야기다.
설치된 스킬은 그대로 슬래시 명령이 된다. 여러 개를 겹쳐 부를 수도 있다.
/github-pr-workflow /test-driven-development 이슈 #123 고치고 PR 올려줘쌓인 것이 쓰레기가 되지 않게 — 큐레이터#
자동으로 배우는 시스템의 진짜 문제는 배우는 게 아니라 쌓이는 것이다. 매번
새 스킬을 만들면 반년 뒤에는 비슷비슷한 문서 수십 개가 목록을 채우고, 그 목록이
매 세션 토큰을 먹는다. Hermes 에 이걸 치우는 장치가 처음부터 들어 있다는 점이
개인적으로 가장 설득력 있었다.
큐레이터는 크론이 아니라 놀고 있을 때 깨어난다. 마지막 실행에서
interval_hours(기본 7일)가 지났고 에이전트가 min_idle_hours(기본 2시간)
이상 쉬었으면 백그라운드로 한 번 돈다.
curator:
  enabled: true
  interval_hours: 168          # 7일
  min_idle_hours: 2
  stale_after_days: 30         # 안 쓰면 stale
  archive_after_days: 90       # 더 안 쓰면 보관소로
  consolidate: false           # LLM 로 합치는 패스 — 기본 꺼짐
  prune_builtins: true
동작은 두 단계다.
- 자동 전이 — LLM 없이 날짜만 본다. 30일이면
stale, 90일이면~/.hermes/skills/.archive/로 옮긴다. - LLM 합치기 — 겹치는 스킬을 우산 하나로 묶는다. 기본은 꺼져 있다. 한 번 돌 때 API 호출이 50~100회씩 나가고 라이브러리 구조를 크게 바꾸기 때문이다.
팁
큐레이터는 절대 삭제하지 않는다. 최악이 보관소로 옮기는 것이고, 그건
되돌릴 수 있다. 게다가 매 실행 전에~/.hermes/skills/를 통째로 tar.gz 로
떠 둔다. 핀을 박은 스킬과 크론 작업이 참조하는 스킬(멈춰 둔 작업 것까지)은
아예 건드리지 않는다. 한 번도 안 쓴 스킬도stale_after_days가 지나기
전에는 보관하지 않는다 — 안 썼다는 것이 필요 없다는 증거는 아니니까.
새로 깔았다면 첫 패스는 한 주기 미뤄진다. 그 사이에 라이브러리를 훑어보고
핀을 박거나 끌 시간을 준다는 뜻이다. 뭘 할지 미리 보려면 이렇게 한다.
hermes curator run --dry-run잘못 배우는 것을 막는 게이트#
"에이전트가 나에 대해 틀린 걸 저장했다"가 이 구조에서 제일 신경 쓰이는
대목이다. 여기에 대한 답이 쓰기 승인 게이트다.
memory:
  write_approval: true     # 기본 false — 자유롭게 저장
skills:
  write_approval: true     # 기본 false
켜면 저장이 바로 안 되고 대기 상태로 쌓인다. 백그라운드 리뷰가 몰래 남기는
것까지 전부 걸린다.
/memory pending             # 대기 중인 기억 (자동 저장분은 [auto] 표시)
/memory approve <id>        # 또는 all
/memory reject <id>
/memory approval on         # 게이트 켜고 끄기 (설정에 남는다)

/skills pending             # 대기 중인 스킬 변경 + 한 줄 요약
/skills diff <id>           # 전체 diff — CLI 나 대시보드에서 보는 게 낫다
/skills approve <id>
기억은 짧아서 채팅창에서 그대로 읽고 판단할 수 있지만, SKILL.md 는 말풍선에
넣기엔 크다. 그래서 스킬 쪽은 채팅에 한 줄 요약만 띄우고 전체 diff 는 CLI 나
~/.hermes/pending/skills/<id>.json 에서 보게 돼 있다.
경고
한 홈(
~/.hermes)에 에이전트 프로세스는 하나만 붙인다. 기억은 자동으로
쓰이고 세션 시작 때 프롬프트로 다시 올라오므로, 둘이 같은 홈을 쓰면 서로의
항목을 겹쳐 쌓아 아무도 쓴 적 없는 상태를 만든다. 두 번째 에이전트에게는
프로필을 따로 준다.
기억 항목은 프롬프트에 그대로 들어가는 값이라, 저장 전에 주입·유출 패턴과
보이지 않는 유니코드를 검사해서 걸리면 막는다.
관리자가 쓸 명령어#
여기부터가 실제로 매일 쓰게 되는 부분이다.
지금 뭘 알고 있나#
hermes journey                 # 배운 것 전체를 시간순 타임라인으로 (별칭: learning, memory-graph)
hermes journey --play          # 쌓여 온 과정을 재생
hermes journey list            # 노드 id 목록 — 스킬 이름과 memory:<소스>:<번호>
cat ~/.hermes/memories/MEMORY.md    # 날것 그대로. 그냥 파일이다
cat ~/.hermes/memories/USER.md
hermes skills list             # 설치된 스킬
hermes curator status          # 마지막 실행, 개수, 핀 목록, 안 쓴 스킬 top 5
hermes memory status           # 외부 메모리 제공자를 붙였다면 그 설정
hermes sessions list           # 최근 세션
hermes sessions stats          # 세션 저장소 통계
hermes insights --days 30      # 최근 30일 사용 분석
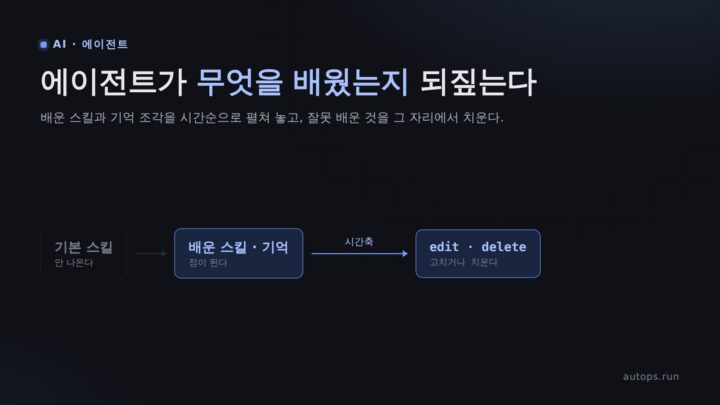
hermes journey 가 이 중 제일 값을 한다. 스킬과 기억을 하나의 시간축에
얹어 보여 줘서, "언제부터 이상한 걸 배웠나"를 눈으로 짚을 수 있다. 이 화면
하나만 따로 본 것은 hermes journey 로 배운 것 되짚기에
정리했다 — 무엇이 점이 되고 무엇이 빠지는지, 잘못 배운 것을 어떻게 치우는지.
기억이 그냥 파일이라는 점도 운영 입장에서는 크다. 블랙박스에 질문해서
알아내는 게 아니라 cat 으로 열어 보고, 이상하면 고치고, 필요 없으면 지운다.
고치고 지우기#
hermes journey edit <노드>      # $EDITOR 로 연다 (SKILL.md 또는 기억 덩어리)
hermes journey delete <노드>    # 스킬은 보관, 기억은 삭제. -y 로 확인 건너뛰기
hermes curator pin <스킬>       # 자동 전이에서 제외 — 중요한 건 박아 둔다
hermes curator unpin <스킬>
hermes curator archive <스킬>   # 지금 당장 보관소로
hermes curator restore <스킬>   # 보관소에서 되살리기
hermes curator list-archived정리#
hermes curator run --dry-run              # 뭘 할지 미리 본다
hermes curator run --background           # 지금 한 번 돌린다
hermes curator prune --days 60            # 60일 이상 안 쓴 것 일괄 보관
hermes sessions prune --older-than 90d --dry-run   # 오래된 세션 (기본 90일)
hermes sessions optimize                  # FTS 인덱스 병합 + VACUUM. 데이터는 안 건드린다
사고가 났을 때#
큐레이터가 아까운 걸 치웠거나, 에이전트가 스킬을 망쳐 놨을 때.
hermes curator rollback --list        # 스냅샷 목록 (이유·크기까지)
hermes curator rollback               # 가장 최근 것으로 되돌린다
hermes curator rollback --id <시각>   # 특정 시점으로
hermes curator ledger --skill <이름>  # 이 스킬에 누가 무엇을 했는지 감사 기록
hermes curator rollback <기록-id> # 그중 한 건만 되돌린다참고
되돌리기도 되돌릴 수 있다. 스킬 트리를 갈아 끼우기 전에
pre-rollback스냅샷을
한 장 더 뜨기 때문에, 잘못 되돌렸으면--id로 그쪽으로 다시 간다.
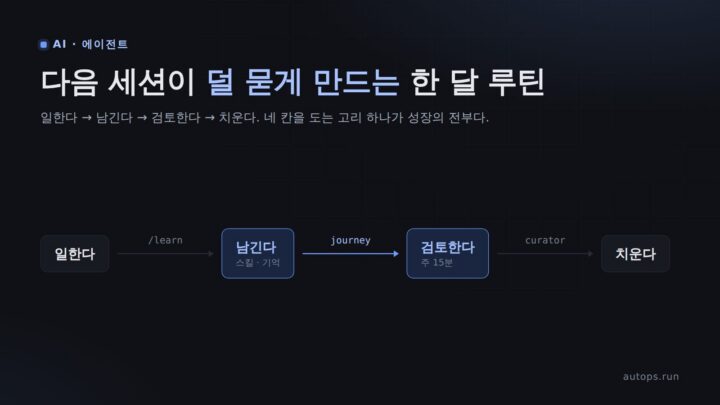
운영 리듬#
| 언제 | 무엇을 |
|---|---|
| 일이 끝날 때마다 | /new — 이거 하나가 나머지를 살린다 |
| 좋은 절차를 찾았을 때 | /learn <방금 한 것> 또는 /refine |
| 주 1회 | hermes journey 로 훑는다 — 이상한 게 배워졌나 |
| 월 1회 | hermes curator status, hermes sessions prune --dry-run |
| 처음 한 달 | write_approval: true 로 두고 뭘 저장하려는지 본다 |
마지막 줄이 실제로 제일 쓸모 있는 조언이다. 한 달쯤 승인하며 지켜보면 이 에이전트가
무엇을 배울 만하다고 판단하는지 감이 온다. 그다음에 게이트를 풀어도 늦지 않다.
정리#
- 기억이 파일이다.
~/.hermes/memories/를 열면 다 보인다. 고치고 지우는 것도 파일을 고치고 지우는 일이다. 무엇을 알고 있는지 물어볼 필요가 없다. - 항상 켜 두는 것은 1,300 토큰으로 묶여 있다. 기억이 늘어난다고 매 턴 비용이 늘지 않는다. 나머지는 필요할 때만 읽힌다.
- 한도가 차면 에러를 낸다. 조용히 밀려나는 것이 없다.
- 배우는 것을 껐다 켤 수 있고, 승인받게 할 수 있고, 되돌릴 수 있다.
write_approval,/memory pending,hermes curator rollback세 가지면 자동 학습을 무섭지 않게 쓸 수 있다. - 쌓인 것을 치우는 장치가 기본으로 들어 있다. 그리고 삭제가 아니라 보관이다.
/new를 안 하면 위의 절반이 안 돈다. 게이트웨이를 쓴다면 특히.
에이전트가 이 기억과 스킬을 언제 읽어서 모델에게 보내는지는 AI 에이전트는 채팅 한 줄을 받으면 안에서 무엇을 하나에 소스로 따라가 정리했다.
참고#
- Persistent Memory — MEMORY.md · USER.md · session_search
- Skills System —
/learn,skill_manage, 승인 게이트 - Curator — 보관·스냅샷·롤백
- CLI 명령 레퍼런스 · 슬래시 명령

댓글