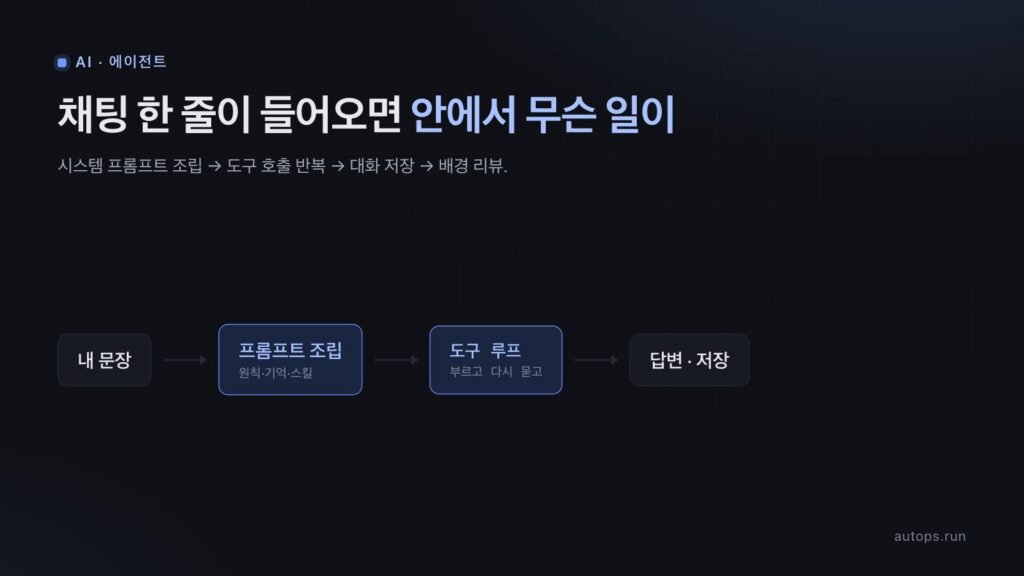
AI 에이전트에 "파드 왜 죽었어?" 하고 물으면 잠시 뒤 답이 온다. 그 사이에 무슨 일이 일어날까.
Hermes 를 설치하고 MCP 를 붙이고
무엇을 기억하는지까지 봤으니, 이번에는 채팅 한 줄이 들어온 순간부터
따라간다.
읽고 나면 "에이전트가 알아서 한다" 가 아니라 어디까지 정해진 절차이고 어디부터 모델의 판단인지
구분할 수 있게 된다. 그 구분이 되어야 에이전트가 엉뚱한 답을 했을 때 어디를 고칠지 알 수 있다.
참고
이 글의 숫자와 코드 줄 번호는 내 맥에 설치한 Hermes Agent v0.21.3 을 직접 뜯어본 것이다.
버전이 오르면 달라질 수 있다. 확인은hermes --version으로 한다.
한 문장으로 먼저#
에이전트가 하는 일은 결국 이 다섯이다.
| 단계 | 하는 일 | 누가 정하나 |
|---|---|---|
| 1 | 보낼 재료를 조립한다 (원칙·기억·스킬 목록) | 프로그램 |
| 2 | 쓸 수 있는 도구 설명을 함께 넘긴다 | 프로그램 |
| 3 | 모델이 도구를 부르면 실행하고 결과를 붙여 다시 묻는다 | 모델 ↔ 프로그램 |
| 4 | 최종 답을 돌려주고 대화를 저장한다 | 프로그램 |
| 5 | 뒤에서 배울 것이 있나 한 번 더 본다 | 프로그램 + 모델 |
모델이 스스로 하는 건 3단계의 판단 하나뿐이다. 나머지는 전부 짜여 있는 절차다.
1단계 — 내 문장 앞에 13,199자가 붙는다#
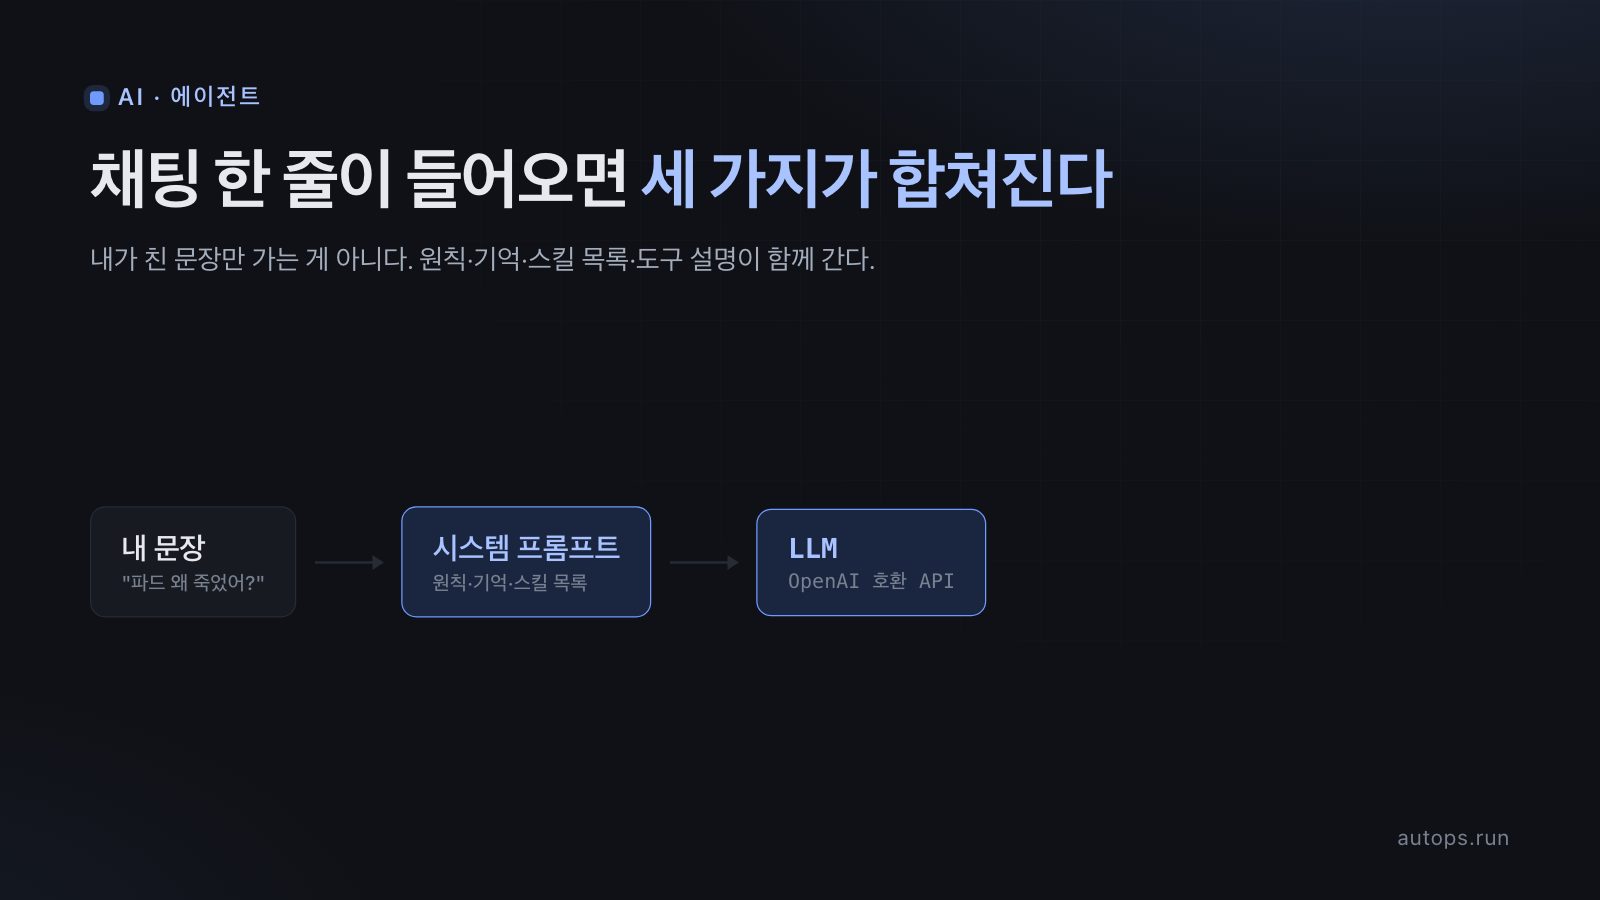
내가 친 문장은 모델에게 그대로 가지 않는다. 앞에 시스템 프롬프트라는 안내문이 붙는다.
"너는 누구고, 무엇을 지켜야 하고, 무엇을 기억하고 있고, 어떤 도구와 스킬이 있다" 를 적은 글이다.
얼마나 긴지 직접 쟀다. Hermes 는 조립한 시스템 프롬프트를 세션 데이터베이스에 저장해 두기 때문에
꺼내 볼 수 있다.
python3 -c "
import sqlite3, os
c = sqlite3.connect(os.path.expanduser('~/.hermes/state.db'))
p = c.execute('select prompt from system_prompts limit 1').fetchone()[0]
print(len(p), '자 /', len(p.splitlines()), '줄')
"
13199 자 / 118 줄내가 친 두 글자("안녕") 앞에 13,199자가 붙었다. 그 안에는 이런 제목들이 들어 있었다.
# Finishing the job          (일을 끝까지 하라는 규칙)
# Parallel tool calls        (서로 상관없는 조회는 한 번에 부르라는 규칙)
## Skill Safety Rule         (스킬 본문이 잘렸으면 다시 불러오라는 규칙)
## Mid-turn user steering    (도중에 사용자가 끼어들었을 때)
## Skills                    (쓸 수 있는 스킬 목록)
# Hermes runtime environment (지금 이 컴퓨터가 어떤 환경인가)
맨 마지막 블록은 이렇게 생겼다. 진짜로 들어 있던 내용이다.
# Hermes runtime environment

Host: macOS (14.8.3)
User home directory: /Users/leejungwook
Current working directory: /Users/leejungwook
모델은 내 컴퓨터를 볼 수 없다. 그래서 프로그램이 알려 준다. 에이전트가 "맥이니까 brew 를 쓰라" 고
답할 수 있는 건 똑똑해서가 아니라 이 줄을 읽었기 때문이다.
조립에는 순서가 있다#
agent/system_prompt.py 의 build_system_prompt_parts() 는 프롬프트를 세 덩이로 나눠 만든다.
| 덩이 | 무엇이 들어가나 | 성격 |
|---|---|---|
| stable | 정체성(SOUL.md), 기본 규칙, 고정된 스킬 | 거의 안 바뀜 |
| context | 프로젝트 문서, 작업 폴더 정보 | 세션마다 다름 |
| volatile | 스킬 목록, 기억(MEMORY.md·USER.md), 시각, 실행 환경 | 가장 자주 바뀜 |
왜 굳이 나눌까. 주석에 이유가 적혀 있다. 요약하면 안 바뀌는 앞부분을 그대로 두어야 캐시가 재사용된다
는 것이다. 같은 앞부분을 다시 보내면 LLM 제공자가 "아까 그거" 로 처리해 돈과 시간을 아낀다. 자주 바뀌는
것을 앞에 두면 그 뒤가 전부 캐시에서 빠진다.
팁
여기서 배울 점 하나. 에이전트 설정을 자주 고치면 비용이 오른다. 스킬 하나를 추가해도 목록이 바뀌어
그 뒤가 다시 계산된다. 실습 중에 설정을 계속 만지면 토큰이 왜 많이 나왔는지 여기서 설명된다.
스킬은 '목록'만 간다#
에이전트가 스킬 100개를 갖고 있어도 본문 100개를 다 보내지 않는다. 시스템 프롬프트에는
이름과 한 줄 설명만 들어간다. 코드에서 그 한 줄을 만드는 곳은 이렇다.
# agent/prompt_builder.py
index_lines.append(f"    - {name}: {desc}" if desc else f"    - {name}")
그리고 목록 위에는 "관련 있어 보이면 skill_view(name) 로 본문을 불러서 따르라" 는 지시가 붙는다.
3단 로딩이다.
목록(이름 + 한 줄) → 필요하면 본문 → 본문 안의 참고 파일내 장비에는 기본 스킬 12개가 깔려 있었다(ls ~/.hermes/skills). 100개가 되어도 프롬프트는
목록만큼만 길어진다.
기억은 글자 수가 정해져 있다#
agent/agent_init.py 를 보면 기억 저장소를 만들 때 한도가 박혀 있다.
agent._memory_store = MemoryStore(
    memory_char_limit=mem_config.get("memory_char_limit", 2200),
    user_char_limit=mem_config.get("user_char_limit", 1375),
MEMORY.md 는 2,200자, USER.md 는 1,375자. 생각보다 아주 작다. 원고지 열 장쯤이다.
그래서 "클러스터 환경 설명"처럼 긴 지식은 기억이 아니라 스킬에 둬야 한다.
앞 글에서 다룬 내용이 코드에서는 이 두 숫자로 나타난다.
2단계 — 도구 설명이 함께 간다#
모델은 kubectl 을 실행할 수 없다. 대신 "이런 도구를 부를 수 있다" 는 설명을 받고, 부르고 싶으면
이름과 인자를 적어 낸다. 실제 실행은 프로그램이 한다.
내 에이전트에 붙여 둔 MCP 서버 둘을 확인하면 이렇다.
hermes mcp list Name Transport Tools Status
kubernetes npx -y kubernetes-mcp-ser... 11 selected ✓ enabled
opensearch uvx opensearch-mcp-server... 8 selected ✓ enabledhermes mcp test kubernetes ✓ Connected (3730ms)
✓ Tools discovered: 14
events_list List Kubernetes events (warnings, errors, state changes...
pods_list List all the Kubernetes pods in the current cluster fro...
pods_log Get the logs of a Kubernetes Pod in the current or prov...
...발견된 14개 중 11개만 골라서 모델에게 보여 준다. 고르는 이유는 운영 에이전트를 만들면서
정리한 것과 같다 — 조회만 시킬 에이전트에게는 조회 도구만 준다.
주의
"읽기 전용 도구"라고 다 안전한 건 아니다.
configuration_view는 kubeconfig 내용을 그대로 돌려주는데,
거기에는 클러스터 접속 토큰이 들어 있다. 목록에서 뺐다. 도구를 줄 때는 이름이 아니라 그 도구가
실제로 무엇을 돌려주는지를 봐야 한다.
3단계 — 모델은 답 대신 도구를 부른다. 그리고 반복한다#
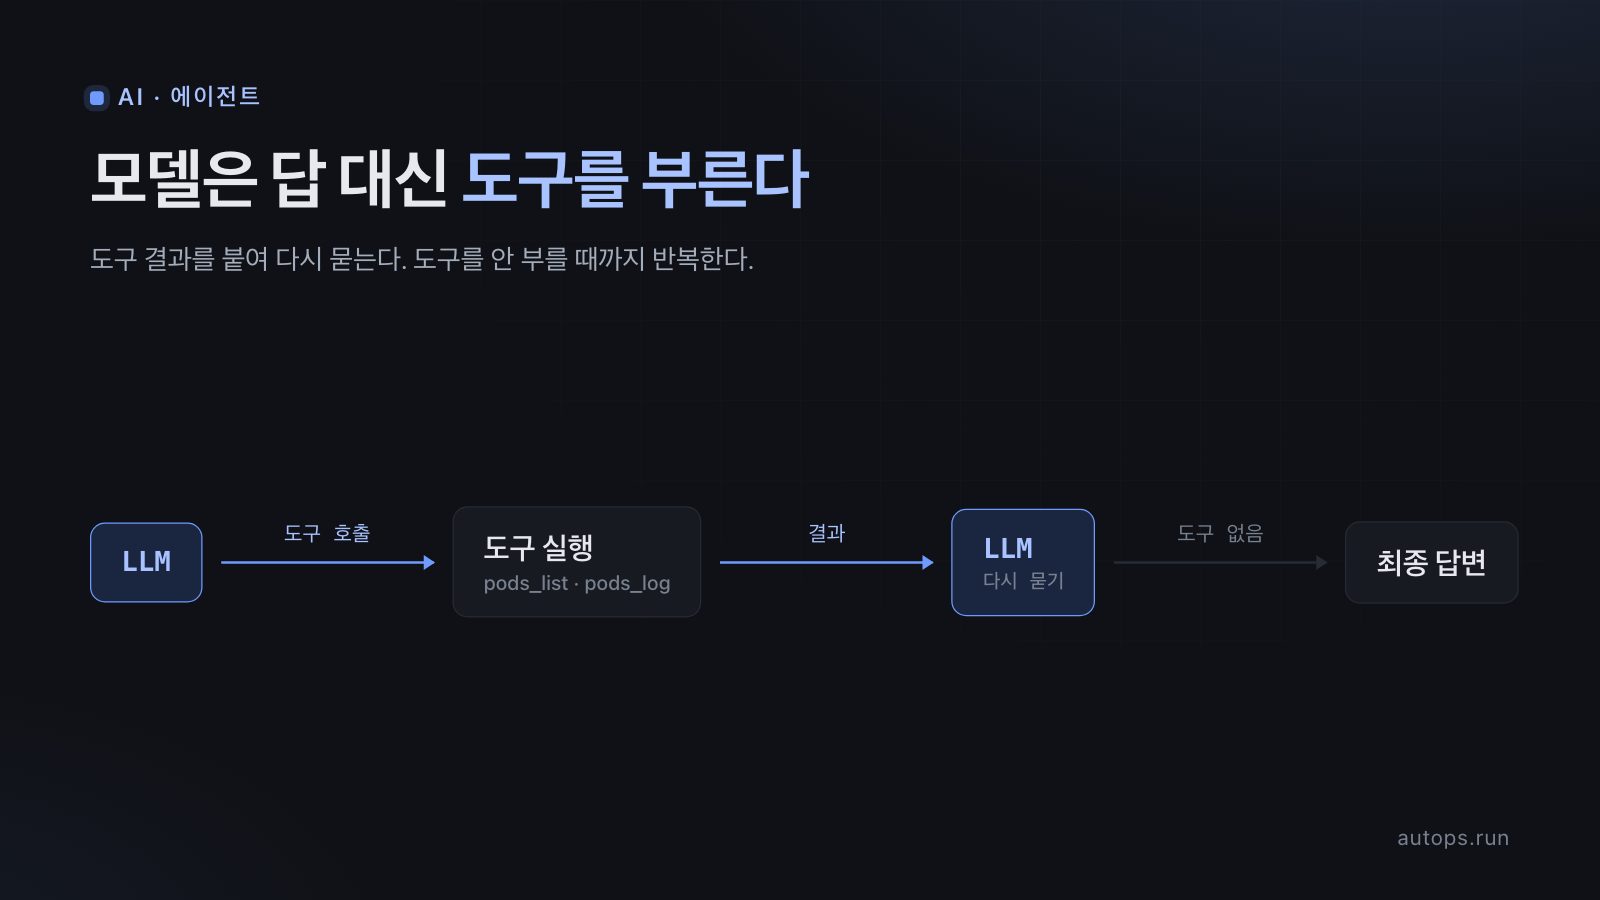
여기가 에이전트의 심장이다. 모델의 응답은 두 가지 중 하나다.
- 사람에게 할 말
- 부르고 싶은 도구 호출 (예:
pods_list(namespace="linkcard"))
도구 호출이 오면 프로그램은 그걸 실행하고, 결과를 대화에 붙여서 모델에게 다시 묻는다.
이 반복을 코드에서 보면 딱 한 줄이다.
# agent/conversation_loop.py — 반복 조건
while (s.api_call_count < agent.max_iterations and agent.iteration_budget.remaining > 0) or agent._budget_grace_call:
    ...
    run_tool_round if s.assistant_message.tool_calls else finish_text_response
읽는 법은 이렇다.
s.assistant_message.tool_calls가 있으면 →run_tool_round(도구 실행하고 한 번 더 돈다)- 없으면 →
finish_text_response(그게 최종 답이다)
그래서 "파드 왜 죽었어?" 한 번에 API 호출이 여러 번 일어난다. 예를 들면 이렇게 흐른다.
나: "linkcard 파드 왜 죽었어?"
  → 모델: pods_list(namespace="linkcard") 불러 줘        [1번째 호출]
  → 프로그램: 실행 결과를 붙임
  → 모델: events_list, pods_log 도 불러 줘                [2번째 호출]
  → 프로그램: 실행 결과를 붙임
  → 모델: "메모리 한도 초과로 OOMKilled 됐다" (도구 없음)  [3번째 호출]
max_iterations 는 이 반복의 상한이다. 기본값은 사실상 무제한(sys.maxsize)이고, 하위 에이전트에게
일을 나눠 줄 때는 250으로 잡혀 있다. 무한 반복을 막는 건 상한이 아니라 예산(iteration_budget)이다.
상관없는 조회는 한꺼번에#
시스템 프롬프트에는 "서로 의존하지 않는 조회는 한 응답에 모아서 부르라" 는 규칙이 들어 있다
(# Parallel tool calls). 실제 실행기도 그에 맞춰 두 가지가 있다.
# agent/tool_executor.py
def execute_tool_calls_concurrent(...)   # 동시에 실행, 결과는 부른 순서대로 붙임
def execute_tool_calls_sequential(...)   # 하나씩 실행
로그·이벤트·파드 목록을 따로따로 세 번 왕복하면 느리고 비싸다. 한 번에 부르면 왕복이 한 번이다.
에이전트가 빠른지 느린지는 모델의 속도만이 아니라 이 습관에서 갈린다.
4단계 — 답을 주고, 전부 저장한다#
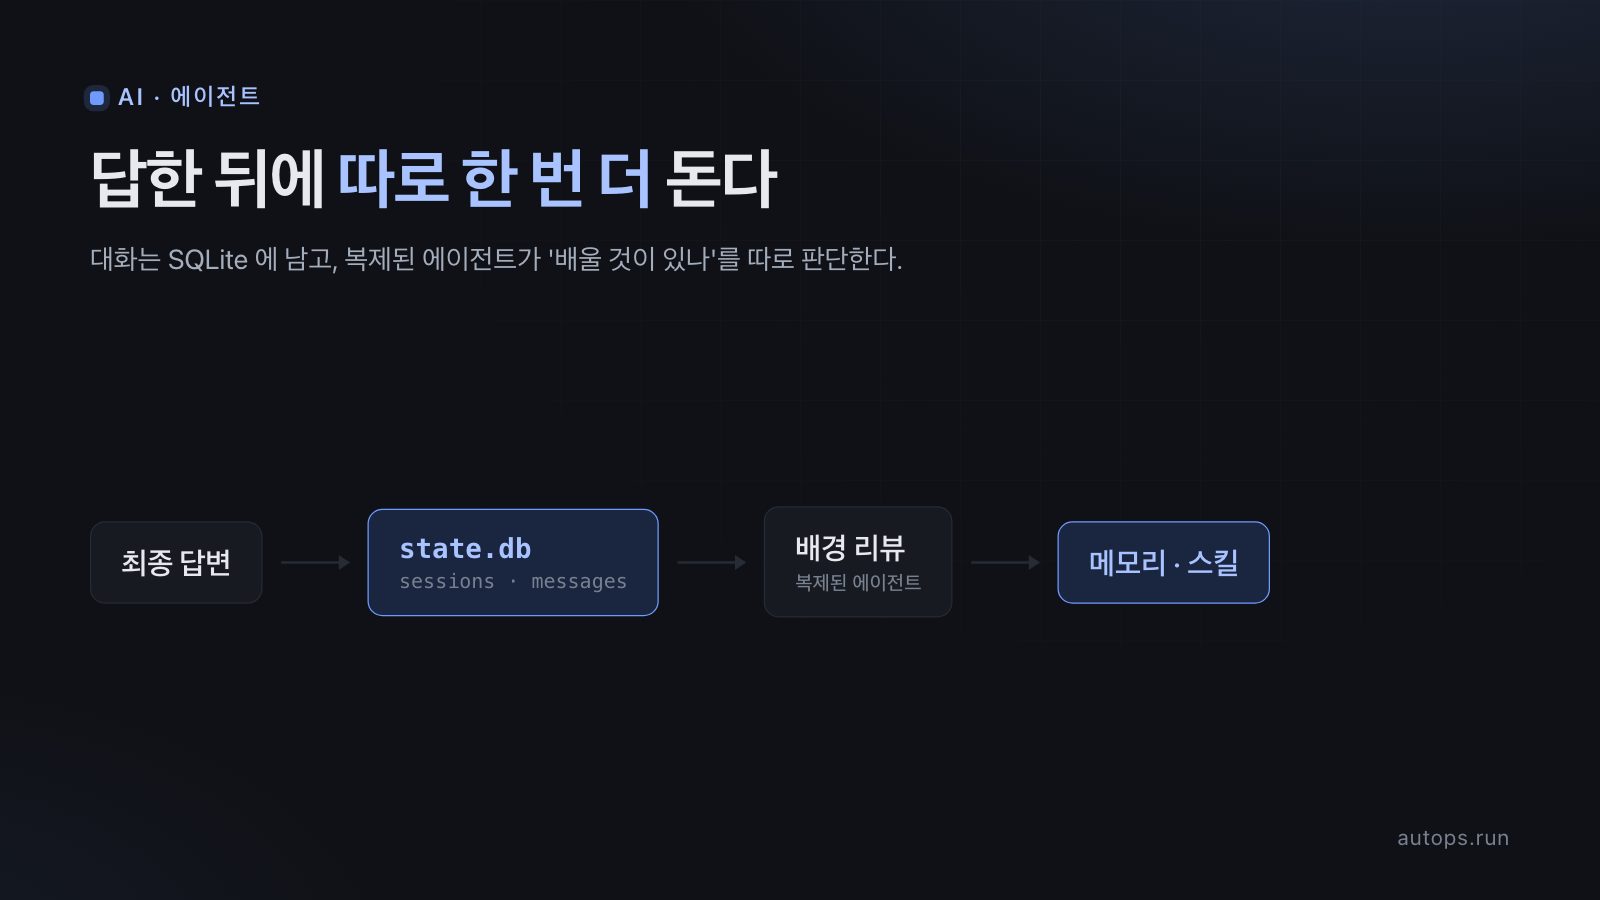
대화는 파일이 아니라 SQLite 데이터베이스 하나에 쌓인다. 테이블이 24개다.
python3 -c "
import sqlite3, os
c = sqlite3.connect(os.path.expanduser('~/.hermes/state.db'))
print([r[0] for r in c.execute("select name from sqlite_master where type='table'")][:6])
"
['schema_version', 'system_prompts', 'sessions', 'messages', 'sqlite_sequence', 'session_model_usage']24개 중 앞 여섯이다(이름순이 아니라 만들어진 순서로 나온다). 이 글에서 중요한 것만 추리면 이렇다.
sessions— 대화 한 건messages— 주고받은 메시지 한 줄씩 (도구 호출과 그 결과 포함)messages_fts— 전문 검색 색인(뒤쪽에 따로 있다). 나중에 "지난번 그 장애 때 뭐였지?" 를 여기서 찾는다system_prompts— 그때 보낸 안내문 전체 (1단계에서 꺼내 본 게 이것이다)session_model_usage— 모델·토큰 사용량
실패해도 남는다#
재미있는 걸 봤다. 나는 아직 LLM 키를 넣지 않아서, 시험 삼아 보낸 메시지가 401 로 거절당했다.
Provider said: HTTP 401: Missing Authentication header그런데 데이터베이스를 열어 보니 이미 들어 있었다.
sessions             1행    id: 20260916_125627_bb64b8
messages             1행    ('user', '안녕', None)
system_prompts       1행    hash=ab01730009df4b38…  길이=13199자
session_model_usage  0행
모델에 닿기도 전에 세션·메시지·시스템 프롬프트가 먼저 저장된다. 모델을 못 불렀으니 사용량만 0행이다.
순서가 이렇다는 걸 알면, 답이 안 왔을 때 "요청이 안 갔나, 모델이 못 답했나" 를 DB 로 가를 수 있다.
5단계 — 답한 뒤에 따로 한 번 더 돈다#
여기가 Hermes 가 "성장하는 에이전트" 라고 불리는 대목이다. 대답이 끝나면 복제된 에이전트가
뒤에서 조용히 한 번 더 돈다. 소스 맨 앞의 설명이 그대로 말해 준다.
# agent/background_review.py
"""Background memory/skill review — fork the agent to evaluate the turn. After every turn
``AIAgent.run_conversation`` may spawn a daemon thread that replays the conversation snapshot in a
forked :class:`AIAgent` and asks "should any skill/memory be saved or updated?"- 매 턴 뒤에 돈다
- 대화 내용을 다시 읽고 "기억하거나 스킬로 남길 게 있나" 를 판단한다
- 판단 결과는 기억·스킬 저장소에 바로 쓴다. 진행 중인 대화는 건드리지 않는다
기본은 켜져 있다. 설정을 못 읽어도 켜진 쪽으로 넘어간다(fail-open).
return is_truthy_value(task.get("enabled"), default=True), task주의
켜져 있다는 건 턴마다 LLM 호출이 한 번 더 있다는 뜻이다. 대화 비용이 생각보다 큰 이유가 여기 있는
경우가 많다. 리뷰를 더 싼 모델로 돌리거나 끌 수 있고, 필요할 때 수동으로 부를 수도 있다.
Hermes 만의 기능들은 이 다섯 단계 어디에 붙나#
여기까지가 "채팅 한 줄"의 기본 경로다. Hermes 에는 그 위에 얹힌 고유 기능이 몇 개 있는데, 전부 위 다섯 단계
중 어딘가에 끼어드는 것이다. 새로운 마법이 아니다.
/learn — "방금 한 걸 스킬로 만들어 둬"#
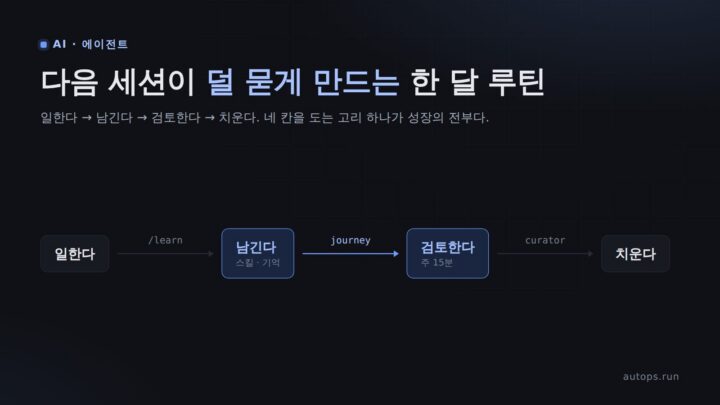
작업을 한 번 끝낸 뒤 /learn 이라고 치면, 그 절차가 다음에 쓸 수 있는 스킬로 저장된다.
/learn                          ← 방금 이 대화에서 한 작업을
/learn https://example.com/docs 이 문서에서 배포 절차만
동작은 단순하다. /learn 은 특별한 명령이 아니라 잘 짜인 부탁 한 건이다.
CLI 가 build_learn_prompt() 로 지시문을 만들어 평소처럼 3단계(도구 루프)에 밀어 넣는다.
# hermes_cli/cli_commands_mixin.py
self._queue_prompt_turn(build_learn_prompt(user_request), "/learn")
지시문에는 이런 내용이 들어 있다. 인자를 비우고 /learn 만 치면 대상은
"이 대화에서 방금 지나온 작업 흐름"이 된다.
- 사용자가 말한 출처를 모은다 — 로컬 파일은
read_file·search_files, URL 은web_extract, "방금 한 것"은 대화 기록에서 - 요청에 붙은 조건("인증 부분만", "폐기된 건 빼고")도 스킬 내용에 반영한다
skill_manage로 저장하되, 비슷한 스킬이 이미 있으면 새로 만들지 말고 그걸 고친다
즉 모델이 자기 도구로 자료를 모아 SKILL.md 를 쓰는 것이고, 새 스킬이 생기면 1단계의 스킬 목록이 한 줄
길어진다. 그 SKILL.md 를 손으로 쓰는 쪽은 Hermes 스킬 만들기에 정리했다.
/refine — 배경 리뷰를 지금 돌리기#
5단계의 배경 리뷰는 턴이 끝나면 저절로 돈다. 그걸 기다리지 않고 지금 돌리는 게 /refine 이다.
/refine
/refine 배포 절차를 스킬로 남겨 줘
같은 기계장치를 쓴다. 대화 스냅샷을 복제한 에이전트가 배경에서 돌고, 진행 중인 대화와 프롬프트 캐시는
건드리지 않는다.
팁
/learn과/refine의 차이는 누가 판단하느냐다./learn은 "이걸 스킬로 만들어" 라고 내가 시키는 것이고,
/refine은 "배울 게 있는지 네가 보고 판단해" 다.
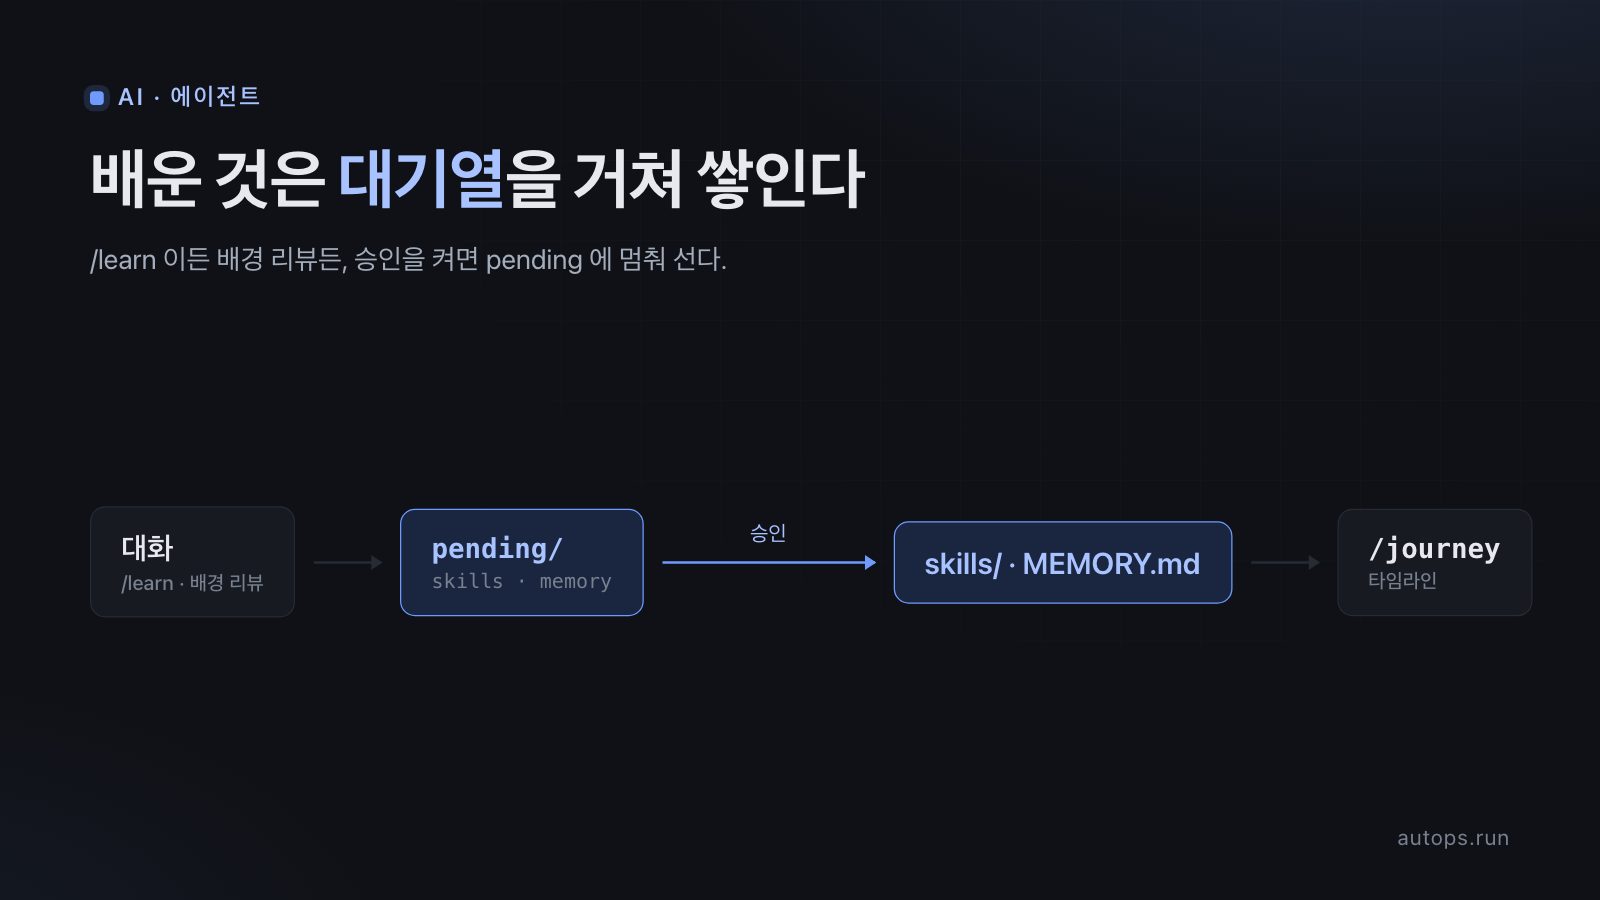
승인 게이트 — 배운 것을 바로 반영하지 않기#
기본값은 바로 쓴다. 에이전트가 기억이나 스킬을 고치면 그대로 파일에 반영된다. 이게 불안하면 켠다.
memory:
  write_approval: true
skills:
  write_approval: true
켜면 쓰기가 파일로 가지 않고 대기열에 멈춘다. 소스에 경로가 그대로 적혀 있다.
<HERMES_HOME>/pending/{memory,skills}/<id>.json쌓인 것은 이렇게 본다.
/skills pending          ← 대기 중인 스킬 쓰기 목록
/skills diff <id>        ← 무엇이 어떻게 바뀌는지
/skills approve <id>     ← 반영
/skills reject <id>      ← 버림
/memory pending          ← 기억 쪽도 같은 방식
포그라운드에서 만든 것이든 배경 리뷰가 만든 것이든 똑같이 걸린다. 자동 학습을 쓰면서도 "사람이 본 것만
반영" 을 지키고 싶을 때 이 스위치 하나면 된다.
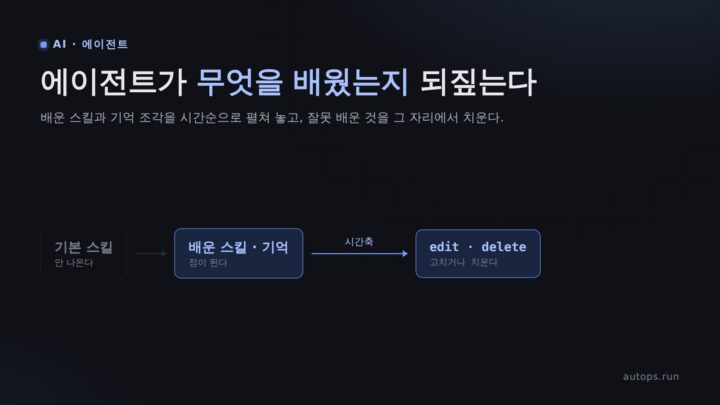
/journey — 무엇을 배웠는지 타임라인으로#
배운 것이 쌓이면 눈으로 보고 싶어진다. /journey(또는 hermes journey)가 그 화면이다.
/journey                 ← 타임라인
/journey list            ← 목록으로
/journey delete <id>     ← 잘못 배운 것 지우기
/journey edit <id>       ← 고치기
무엇을 모아서 그리는지는 agent/learning_graph.py 의 설명에 적혀 있다.
- 배운 스킬(기본 제공 스킬 말고, 에이전트가 만들었거나 실제로 쓴 것)과
MEMORY.md·USER.md의 각 조각이 점(노드)이 된다 - 스킬끼리의 선은 스킬 머리말의
related_skills에서 온다 - 기억과 스킬 사이의 선은 낱말이 겹치는 정도로 이어 준다 (기억 하나당 상위 4개)
- 언제 배웠는지·몇 번 썼는지는
~/.hermes/skills/.usage.json이라는 사용 기록 파일에서 온다
지우고 고칠 수 있다는 게 중요하다. 잘못 배운 것을 치우는 창구가 여기다.
/compress — 대화가 길어지면 요약해서 줄인다#
3단계의 루프가 길어지면 대화가 모델의 한도를 넘는다. 그래서 Hermes 는 앞부분을 요약으로 갈아 끼운다.
기본으로 켜져 있고, 기본 기준은 이렇다.
compression:
  enabled: true
  threshold: 0.50   # 모델 컨텍스트 한도의 50% 를 넘으면 압축
컨텍스트 창이 512K 미만인 모델은 0.75 로 올려 잡는다. 절반이나 남았는데 미리 줄이면 손해라서다.
직접 부를 수도 있다.
/compress                  ← 지금 요약해서 줄여라
/compress here 5           ← 최근 5번 주고받은 것만 그대로 두고 나머지를 요약
/compress focus 배포 절차 ← 요약할 때 이 주제를 남겨라주의
요약은 손실이다. 줄인 부분은 원문이 아니라 요약문으로 남는다. 그래서 중요한 사실은 대화에 떠 있게 두지
말고 기억(MEMORY.md)이나 스킬로 내려두는 편이 안전하다. 기억은 요약과 무관하게 시스템 프롬프트에 다시
실린다.
/new — 대화를 끊는 것이 왜 기능인가#
/new(별칭 /reset)는 세션 번호와 대화 기록을 새로 시작한다. 별것 아닌 것 같지만 앞의 다섯 단계를
알고 나면 이게 왜 중요한지 보인다.
- 1단계의 기억은 세션이 시작할 때 한 번 박히는 스냅샷이다. 방금 배운 것을 반영해서 보려면 새 세션이어야 한다.
- 3단계의 루프는 대화가 길수록 매번 보내는 양이 늘어난다. 안 끊으면 같은 질문이 점점 비싸진다.
- 4단계의 세션이 하나로 뭉쳐 있으면, 나중에 "그때 그 장애" 를 찾기도 어렵다.
한 가지 일 = 한 세션이 기본기다.
session_search — 지난 대화를 뒤지는 도구#
4단계에서 본 messages_fts 테이블이 이 도구의 바탕이다. 에이전트가 "예전에 비슷한 걸 본 적 있나?" 를
스스로 검색할 수 있다. 모델을 부르지 않고 SQLite 전문 검색으로 원문을 찾아오므로 돈이 들지 않는다.
hermes curator — 쌓인 스킬을 치우는 청소부#
스킬이 쌓이면 안 쓰는 것이 생긴다. 큐레이터가 사용 기록(.usage.json)을 보고 오래 안 쓴 스킬을 보관 처리한다.
명령은 hermes curator 아래에 있다 — 도움말에는 status, run, pause, pin 이 적혀 있다.
pin 은 "이건 안 쓰는 것처럼 보여도 치우지 마라" 는 표시다.
한눈에#
| 기능 | 어느 단계에 끼어드나 | 한 줄 |
|---|---|---|
/learn |
3단계 (도구 루프) | 잘 짜인 부탁을 넣어 스킬을 쓰게 한다 |
/refine |
5단계 | 배경 리뷰를 지금 돌린다 |
| 승인 게이트 | 5단계 뒤 | 쓰기를 pending/ 에 세워 둔다 |
/journey |
저장된 결과 보기 | 배운 스킬·기억을 타임라인으로, 지우고 고친다 |
/compress |
3단계 | 길어진 대화를 요약으로 갈아 끼운다 |
/new |
1·4단계 | 기억 스냅샷을 새로 뜨고 대화를 끊는다 |
session_search |
3단계의 도구 | 지난 대화를 공짜로 검색한다 |
hermes curator |
저장된 결과 관리 | 안 쓰는 스킬을 보관한다 |
그래서 어디를 고치면 되나#
처음에 말한 구분으로 돌아온다. 에이전트가 이상하게 답했을 때 볼 곳이 다르다.
| 증상 | 원인이 있을 만한 곳 |
|---|---|
| 우리 환경을 모르는 소리를 한다 | 1단계 — 기억(MEMORY.md)이나 환경 스킬에 그 사실이 없다 |
| 있는 절차를 안 따른다 | 1단계 — 스킬 설명이 모호해 목록에서 안 걸렸다 |
| 조회를 못 한다 | 2단계 — 그 도구가 화이트리스트에서 빠졌다 |
| 한 번 묻는데 너무 느리다·비싸다 | 3단계 — 도구를 하나씩 부르며 왕복이 많다 |
| 지난 장애를 기억 못 한다 | 4단계 — 세션 검색을 안 썼거나 세션이 안 끊겼다 |
| 이상한 걸 배워 버렸다 | 5단계 — 배경 리뷰가 쓴 것. 승인 게이트로 막는다 |
정리#
- 내 문장은 그대로 가지 않는다. 원칙·기억·스킬 목록·환경 정보가 붙어 13,199자가 됐다. 그 전부가 매번 모델에게 간다.
- 프롬프트는 안 바뀌는 것부터 순서대로 쌓는다. 캐시를 재사용하기 위해서다. 설정을 자주 고치면 비용이 오른다.
- 스킬은 목록만 간다. 이름과 한 줄 설명뿐이고, 본문은 모델이
skill_view로 부를 때 온다. - 기억은 2,200자·1,375자로 작다. 긴 지식은 기억이 아니라 스킬에 둔다.
- 모델은 답 대신 도구를 부를 수 있고, 프로그램은 결과를 붙여 다시 묻는다. 도구를 안 부를 때가 최종 답이다.
- 대화는 SQLite 에 남는다. 모델 호출이 401 로 실패해도 세션·메시지·시스템 프롬프트는 이미 저장돼 있었다.
- 답한 뒤 복제된 에이전트가 한 번 더 돈다. 기본으로 켜져 있고, 그만큼 호출이 늘어난다.

댓글