"마이크로서비스" 라는 말은 많이 듣는데, 막상 직접 만들어 보려면 어디서
시작해야 할지 막막하다. 책을 펴면 추상적인 그림부터 나오고, 따라 해 보려면
쿠버네티스·메시지큐·로그수집이 한꺼번에 쏟아진다.
이 연재는 작은 서비스 하나를 실제로 만들면서 그것들을 하나씩 붙여 본다.
아홉 편이고, 매 편은 앞서 만든 kind 클러스터 위에서
돌아간다.
무엇을 만드나#
링크 미리보기 카드 생성기다. 주소를 넣으면 그 페이지를 긁어와
제목·설명·썸네일이 담긴 카드 이미지를 만들어 준다.
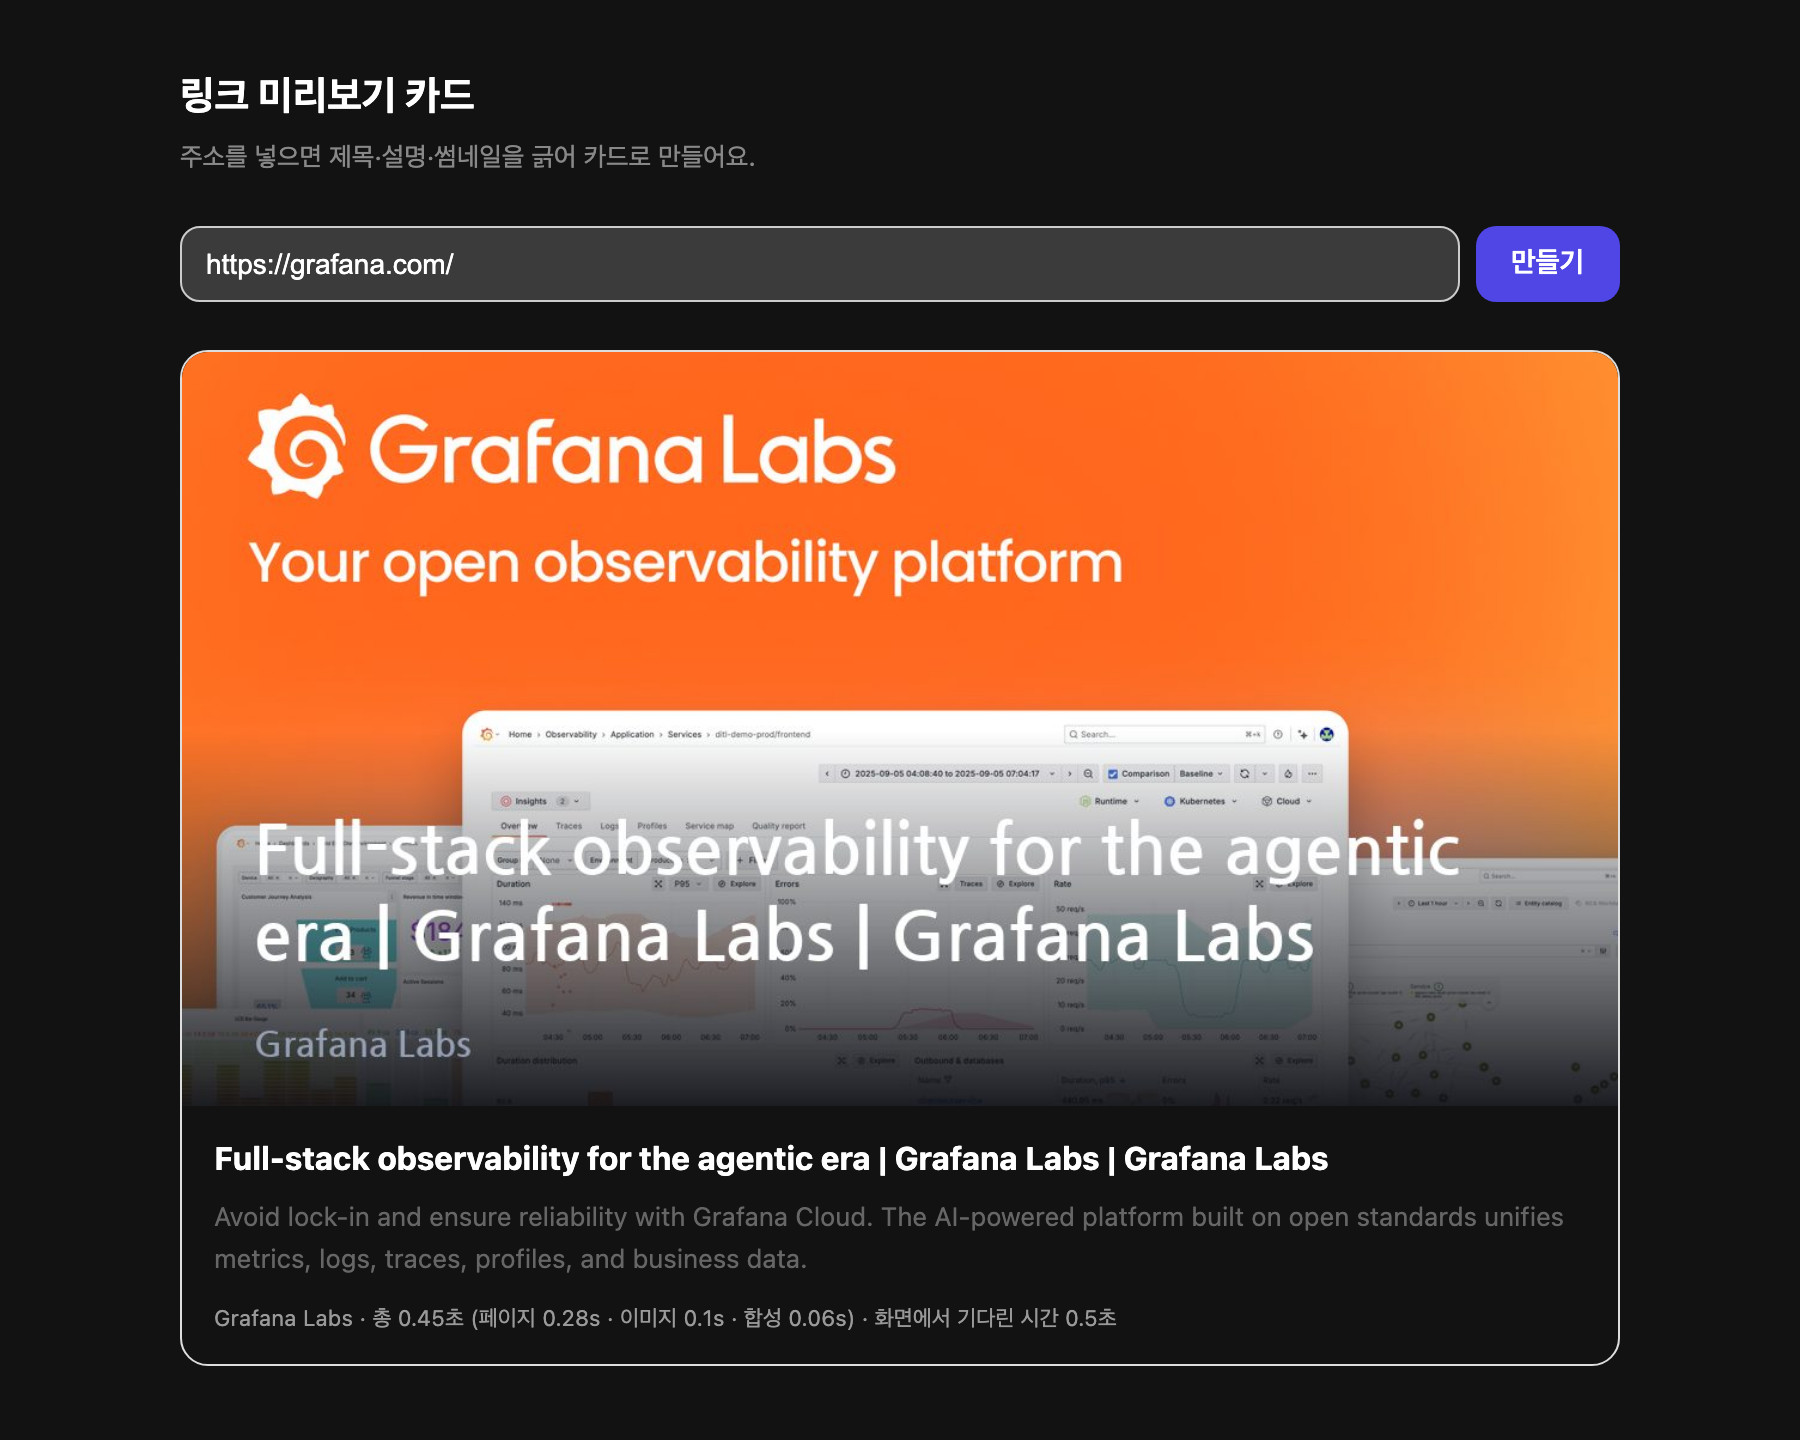
카카오톡이나 슬랙에 링크를 붙이면 뜨는 그 카드를 직접 만드는 것이다.
참고
왜 하필 이 앱인가. 마이크로서비스를 배우려면 성격이 다른 일이 섞여
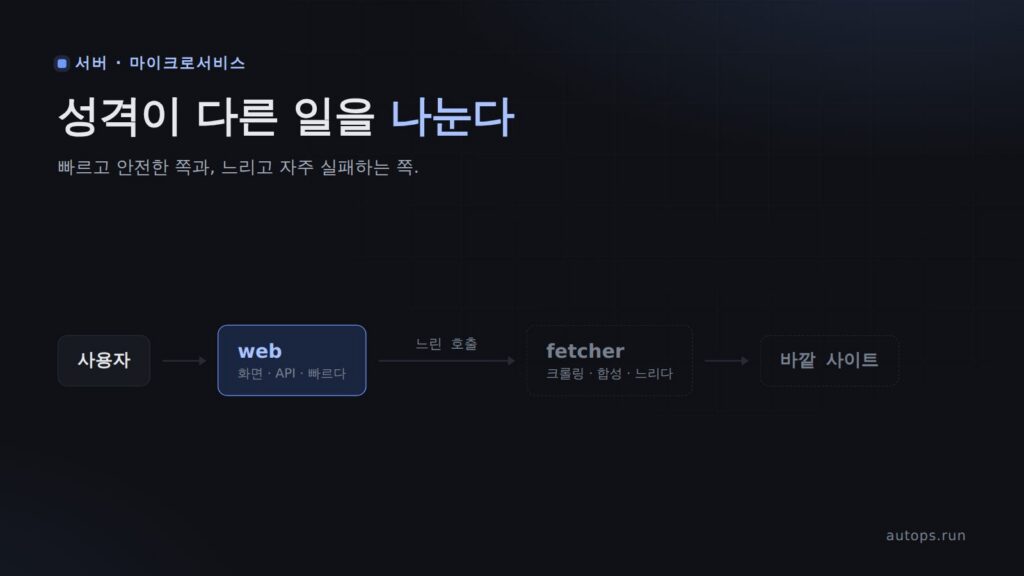
있어야 한다. 이 앱에는 "사용자 요청을 받는 일"과 "바깥 사이트를 긁어 오는
일"이 있다. 앞의 것은 빠르고 안전하지만, 뒤의 것은 느리고 자주 실패한다.
성격이 다르니 나눌 이유가 생긴다.
왜 쪼개나#
처음 듣는 분을 위해 짚고 간다. 프로그램 하나에 다 넣으면 안 되나?
된다. 오히려 작은 서비스는 그게 낫다. 쪼개는 건 불편을 감수하고 얻는
것이 있을 때만 의미가 있다.
| 한 덩어리 | 쪼갠 뒤 |
|---|---|
| 배포하면 전부 다시 뜬다 | 고친 부분만 다시 뜬다 |
| 한 곳이 느려지면 전체가 느려진다 | 느린 쪽만 따로 늘릴 수 있다 |
| 한 곳이 죽으면 전체가 죽는다 | 나머지는 산다 |
| 구조가 단순하다 | 네트워크·장애·추적이 새 숙제로 생긴다 |
마지막 줄이 중요하다. 쪼개면 공짜로 좋아지는 게 아니라 새 문제가 생긴다.
이 연재의 3편부터는 대부분 그 새 문제를 다룬다.
우리가 쪼갤 모양#
두 개로 시작한다.
사용자 ──▶  web  ──▶  fetcher  ──▶  바깥 사이트
화면·API 크롤링·카드합성- web — 사용자가 보는 화면과 API. 빠르고 가볍다.
- fetcher — 바깥 사이트를 받아 오고 카드 이미지를 합성한다. 느리고 자주 실패한다.
연재가 진행되면 이렇게 늘어난다.
사용자 ──▶ web ──▶ RabbitMQ ──▶ worker ──▶ 바깥 사이트
                                   │
        모든 서비스의 로그 ──▶ Fluentd ──▶ OpenSearch ──▶ 대시보드
아홉 편의 차례#
| 편 | 다루는 것 |
|---|---|
| 1 | 지금 글. 무엇을 왜 쪼개나, git 으로 배포한다는 것 |
| 2 | 첫 서비스를 ArgoCD 로 올리기 |
| 3 | 평균은 0.4초인데 왜 7초를 기다릴까 — 워커가 막히는 순간 |
| 4 | 기다리게 하지 않는다 — RabbitMQ 로 넘기기 |
| 5 | 실패하면 어떻게 되나 — ack·재시도·DLQ |
| 6 | 흩어진 로그를 한곳으로 — Fluentd |
| 7 | 한 요청을 끝까지 쫓아가기 |
| 8 | OpenSearch 에 넣고 찾아보기 |
| 9 | 대시보드로 병목 찾기 |
3편 제목이 이상해 보일 수 있다. 실제로 재 본 숫자다. 2편까지 만들어 놓고
측정했더니 평균 0.41초인 서비스가 최악의 경우 7초를 기다리게 했다.
왜 그런지가 4편에서 큐를 도입하는 이유가 된다.
배포는 kubectl 이 아니라 git 으로 한다#
이 연재의 규칙이 하나 있다. 클러스터를 직접 건드리지 않는다.
보통은 이렇게 한다.
kubectl apply -f deployment.yaml # 내 손으로 클러스터를 바꾼다이 연재에서는 이렇게 한다.
git commit -m "fetcher 를 v2 로 올린다"
git push                              # 끝. 나머지는 ArgoCD 가 한다
ArgoCD 가 git 저장소를 지켜보고 있다가, 커밋이 올라오면 클러스터를 거기에
맞춘다. 이런 방식을 GitOps 라고 부른다.
참고
GitOps 를 한 줄로 줄이면. git 에 적힌 것이 정답이고, 클러스터를 거기에
맞춘다. 무엇을 왜 바꿨는지가 커밋으로 남고, 되돌리려면git revert한 번이면
된다. ArgoCD 를 올리는 과정은
kind 클러스터에 ArgoCD 올리기에 따로 정리해 두었다.
실제로 이렇게 돈다. 매니페스트의 이미지 태그를 v1 에서 v2 로 바꿔 커밋했을 때다.
+0초   Synced/Healthy      image=linkcard-fetcher:v1
+3초   Synced/Progressing  image=linkcard-fetcher:v2
+15초  Synced/Healthy      image=linkcard-fetcher:v2
푸시하고 15초 만에 새 버전으로 갈렸다. 그동안 내가 클러스터에 친 명령은 없다.
주의
대신 잃는 것도 있다. ArgoCD 의 자동 동기화를 켜 두면
kubectl scale같은
손수정은 1초도 안 되어 git 의 상태로 되돌아간다. 처음엔 "왜 자꾸
원복되지" 하고 당황하게 되는데, 그게 정상 동작이다.
준비물#
따라 하실 분을 위해 적어 둔다.
- 쿠버네티스 클러스터. 없으면 M1 맥에 kind 로 세우기부터
- 그 위에 ArgoCD
- git 저장소 하나 (공개로 두면 인증 설정이 필요 없다)
- 메모리 여유 4GB 이상. 뒤에서 OpenSearch 가 꽤 먹는다
팁
나는 Docker Desktop 메모리를 7.7GB 에서 11.7GB 로 올려 두고 시작했다.
kind 클러스터가 이미 4GB 를 쓰고 있어서, 그대로 두면 8편의 OpenSearch 에서
막힌다. 미리 올려 두는 편이 낫다.
오늘 만들어 둔 것#
web 과 fetcher 두 서비스를 클러스터에 올렸고, ArgoCD 가 물고 있다.
linkcard-fetcher-5f4464878f-thdsk   1/1   Running
linkcard-web-6f9c944dcc-6x587       1/1   Running
linkcard-web-6f9c944dcc-gzmht       1/1   Running
web 이 두 개인 것에 주목하자. 가볍고 빠른 쪽이라 여러 개를 띄워 두었다.
fetcher 는 하나다. 이 불균형이 3편에서 문제를 일으킨다.
정리#
- 쪼개는 건 공짜가 아니다. 배포·확장·장애 격리를 얻는 대신 네트워크·추적· 실패 처리가 새 숙제로 온다. 이 연재의 절반은 그 숙제 이야기다.
- 성격이 다른 일을 나눈다. 빠르고 안전한 일(화면·API)과 느리고 자주 실패하는 일(바깥 사이트 크롤링)을 한 덩어리에 두지 않는다.
- 배포는 git 커밋으로 한다. 커밋이 곧 배포 기록이고, 되돌리기는
git revert다. - 다음 편 쿠버네티스에 첫 서비스 두 개 올리기에서는 이 두 서비스를 어떻게 매니페스트로 적고 ArgoCD 에 맡겼는지 한 줄씩 짚는다.

댓글