앞 편에서 흩어진 로그를 한곳에 모았다. 그런데 작업 하나를 찾을 때는 여전히
job=ebc49322e05a 같은 글자를 문자열로 뒤졌다. 게다가 그 작업이 어느 HTTP 요청에서 시작됐는지는
로그만 봐서는 알 수 없었다.
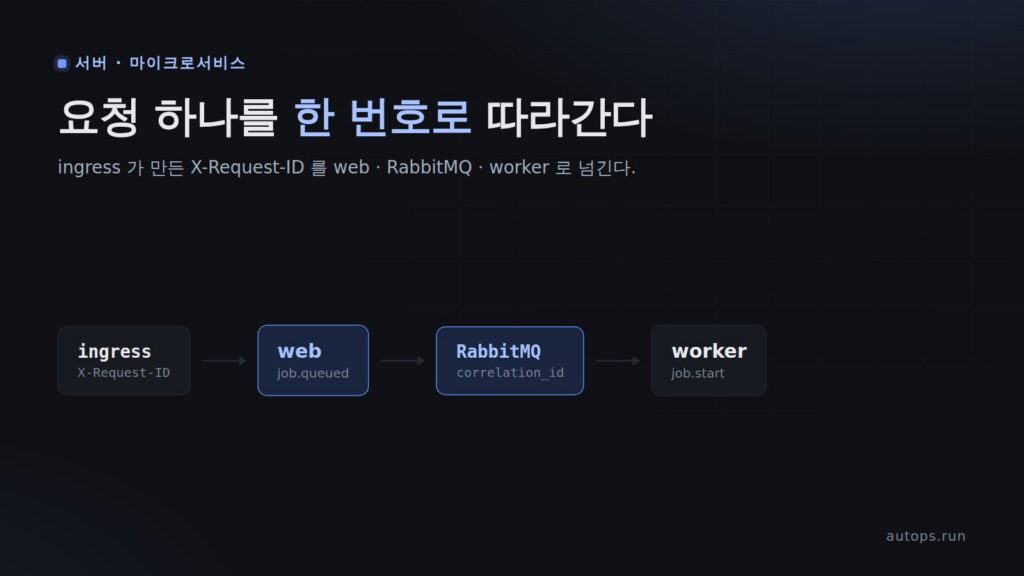
이번 편은 요청 하나에 번호 하나를 붙여, 들어온 순간부터 끝날 때까지 그 번호로 따라간다.
무엇을 만드는가#
| 전 | 후 | |
|---|---|---|
| 앱 로그 모양 | 사람이 읽는 글자 | 사건 이름이 붙은 JSON 한 줄 |
| 요청 번호가 찍힌 곳 | ingress 접근 로그 한 곳 | ingress · web · RabbitMQ 메시지 · worker |
| 작업 하나의 로그 중 번호가 든 줄 | 0줄 | 15줄 전부 |
| ingress 로그 수집 | 안 됨 | 됨 (칸으로 쪼개서) |
| 접수 응답 | job_id 만 |
job_id + request_id |
흐름은 이렇다.
브라우저 ─▶ ingress-nginx ─▶ web ─▶ RabbitMQ ─▶ worker ─▶ web(/internal/result)
            X-Request-ID     로그    correlation_id  로그     X-Request-ID 헤더
만들어 붙임 에 찍음 칸에 실음 에 찍음 로 다시 실음준비물#
- 지금까지 따라온 kind 클러스터와 ArgoCD, gitops 저장소
- 앞 편의 Fluentd forwarder · aggregator
- 걸리는 시간: 코드 수정 30분, 배포와 확인 10분
0. 먼저 지금 상태를 잰다#
바꾸기 전에 얼마나 안 이어지는지 재 둔다. 번호를 직접 정해서 요청을 넣는다.
X-Request-ID 헤더를 주면 ingress-nginx 는 새로 만들지 않고 그 번호를 그대로 쓴다.
curl -s -X POST http://localhost/linkcard/api/cards
  -H 'Content-Type: application/json'
  -H 'X-Request-ID: before-7th-0001'
  -d '{"url":"https://mock.httpstatus.io/503"}'
결과를 세어 보면 이렇다.
| 확인한 것 | 결과 |
|---|---|
| 접수 응답에 요청 번호가 있나 | 없음 (job_id 만 옴) |
ingress 접근 로그에 before-7th-0001 이 있나 |
있음 (줄 맨 끝) |
| 집계기에 모인 이 작업의 로그 | 5줄 |
그중 before-7th-0001 이 든 줄 |
0줄 |
| 집계기에 모인 ingress 로그 | 0건 |
| forwarder 가 떠 있는 노드 | lab-worker, lab-worker2 (control-plane 은 없음) |
번호는 이미 만들어지고 있었다. 앱이 받아서 쓰지 않았을 뿐이다.
1. 번호는 ingress-nginx 가 이미 만든다#
ingress-nginx 는 요청마다 X-Request-ID 를 만들어 뒤쪽 서비스로 넘기고, 접근 로그 맨 끝에도 찍는다.
요청에 이미 그 헤더가 있으면 새로 만들지 않고 그대로 넘긴다. 실제 줄이다.
172.18.0.1 - - [14/Sep/2026:23:36:31 +0000] "POST /linkcard/api/cards HTTP/1.1" 202 107 "-" "Python-urllib/3.9" 254 0.040 [linkcard-linkcard-web-8000] [] 10.244.120.145:8000 107 0.038 202 trace-7th-0001맨 끝의 trace-7th-0001 이 요청 번호다. web 입장에서는 요청 헤더에 번호가 들어와 있으니 읽기만 하면 된다.
참고
이런 번호를 흔히 트레이스 ID, 요청 ID, 상관 ID(correlation ID) 라고 부른다. 이름은 달라도
뜻은 같다 — "이 줄들은 같은 요청에서 나왔다" 를 표시하는 꼬리표다. 번호를 따로 만들 필요가 없는 게
핵심이다. 가장 앞단(여기선 ingress)이 만들고, 뒤쪽은 받아서 넘기기만 한다.
2. web — 번호를 받아 로그에 찍고, 메시지에 싣는다#
로그를 JSON 한 줄로#
먼저 로그 모양부터 바꾼다. 사람이 읽는 글자 대신 사건 이름이 붙은 JSON 한 줄로 남긴다.
그래야 Fluentd 가 request_id 를 글자에서 뒤지지 않고 칸(필드) 으로 읽는다.
def log(event, **fields):
    """한 줄에 JSON 하나."""
    fields = {k: v for k, v in fields.items() if v is not None}
    sys.stdout.write(_json.dumps({"event": event, **fields}, ensure_ascii=False) + "n")
    sys.stdout.flush()


def _request_id():
    """ingress-nginx 가 붙여 준 요청 번호. 없으면(파드에 직접 들어온 요청) 새로 만든다."""
return request.headers.get("X-Request-ID") or uuid.uuid4().hex주의
Flask 의
app.logger로 JSON 을 남기면 안 된다. gunicorn 아래서 돌면 줄 앞에[시각] [pid] [INFO]
같은 머리말이 붙어서 한 줄 전체가 JSON 이 아니게 된다. Fluentd 는 그 줄을 펼치지 못하고 글자로
넘긴다. 그래서 표준 출력에 JSON 만 직접 쓴다.
메시지의 correlation_id 칸에 싣는다#
web 과 worker 사이에는 HTTP 가 없다. RabbitMQ 메시지가 오간다. 그러니 번호도 메시지에 실어야
worker 까지 간다. AMQP 메시지에는 이런 용도로 쓰라고 correlation_id 라는 칸이 따로 있다.
def _publish(job_id, url, request_id):
    ...
        ch.basic_publish(
            exchange="", routing_key=QUEUE,
            body=_json.dumps({"job_id": job_id, "url": url}),
            properties=pika.BasicProperties(
                delivery_mode=2,
                content_type="application/json",
                correlation_id=request_id),
)본문(body)에 넣어도 동작은 한다. 하지만 번호는 작업 내용이 아니라 꼬리표다. 속성 칸에 두면
작업 내용을 건드리지 않고, RabbitMQ 관리 화면에서도 따로 보인다.
접수할 때는 사건을 남기고, 응답에도 번호를 돌려준다. 사용자가 "안 돼요" 하고 문의할 때 이 번호를
알려 주면 바로 찾을 수 있다.
    _save(job_id, {"status": "queued", "url": url, "queued_at": started, "request_id": rid})
    log("job.queued", request_id=rid, job_id=job_id, url=url,
        accept_ms=round((time.time() - started) * 1000, 1))
    return jsonify(ok=True, job_id=job_id, request_id=rid, status="queued",
                   accept_elapsed=round(time.time() - started, 3)), 202
사건 이름을 정직하게#
앞 편 로그에는 재시도 중간 보고에도 job done 이라고 찍혀서 헷갈렸다. 워커가 보낸 상태를
사건 이름에 그대로 쓴다.
    log(f"result.{status}", request_id=rid, job_id=job_id, attempt=d.get("attempt"),
        total_wait=waited, error=(str(d["error"])[:120] if d.get("error") else None))
이제 result.retrying, result.done, result.failed 로 갈린다.
3. worker — 번호를 읽고, 다시 넣을 때도 넘긴다#
worker 는 메시지에서 번호를 꺼내 모든 로그에 붙인다.
def handle(ch, method, props, body):
    headers = dict(props.headers or {})
    attempt = int(headers.get("x-attempt", 1))
    request_id = props.correlation_id or ""
    ...
    log("job.start", request_id=request_id, job_id=job_id, attempt=attempt,
        max_attempts=MAX_ATTEMPTS, redelivered=method.redelivered, url=url)
여기까지는 쉽다. 빠뜨리기 쉬운 곳은 재시도다.
def publish(ch, queue, body, headers, request_id):
    ch.basic_publish(
        exchange="", routing_key=queue, body=body,
        properties=pika.BasicProperties(
            delivery_mode=2, content_type="application/json",
            headers=headers, correlation_id=request_id or None))
재시도 큐와 DLQ 로 보낼 때 모두 이 함수를 쓴다.
주의
재시도 편에서 메시지를 재시도 큐에 새로 발행했다.
BasicProperties를 새로
만들면 원래 메시지의 속성은 하나도 따라오지 않는다.headers만 복사하고correlation_id를 빼먹으면,
첫 시도는 번호가 찍히는데 두 번째 시도부터는 번호가 끊긴다. 가장 보고 싶은 게 "왜 세 번이나
실패했나" 인데, 바로 그 줄들이 추적에서 빠진다.
worker 가 web 에 결과를 돌려줄 때도 번호를 헤더에 싣는다. 이 요청은 클러스터 안에서 web 으로 곧장 가서
ingress 를 거치지 않는다. 직접 실어 주지 않으면 web 접근 로그의 그 줄에는 번호가 없다.
def report(job_id, request_id, payload):
    body = json.dumps({"job_id": job_id, "request_id": request_id, **payload}).encode()
    headers = {"Content-Type": "application/json"}
    if request_id:
        headers["X-Request-ID"] = request_id
    req = urllib.request.Request(RESULT_URL, data=body, headers=headers)
4. gunicorn 접근 로그도 JSON 으로#
gunicorn 이 남기는 접근 로그(POST /api/cards 202 같은 줄)도 JSON 으로 바꾸고 번호를 찍는다.
명령줄 옵션으로 넣으면 따옴표가 복잡해지니 설정 파일로 뺐다.
# apps/linkcard/web/gunicorn.conf.py
bind = "0.0.0.0:8000"
workers = 2
worker_class = "sync"
timeout = 60

accesslog = "-"
access_log_format = (
    '{"event":"http.access","request_id":"%({x-request-id}i)s",'
    '"method":"%(m)s","path":"%(U)s","status":%(s)s,"ms":%(M)s}'
)%({x-request-id}i)s— 요청 헤더 값. 헤더가 없으면-가 찍힌다.%(M)s— 처리 시간(밀리초).
Dockerfile 은 설정 파일을 복사하고 그걸 읽게 한다.
COPY app.py gunicorn.conf.py ./
CMD ["gunicorn", "-c", "gunicorn.conf.py", "app:app"]
노드에 쌓인 원본 파일을 보면 두 줄이 모두 JSON 이다.
2026-09-14T23:36:31.861193555Z stdout F {"event": "job.queued", "request_id": "trace-7th-0001", "job_id": "5b485a33fdf3", "url": "https://mock.httpstatus.io/503", "accept_ms": 32.3}
2026-09-14T23:36:31.861929847Z stdout F {"event":"http.access","request_id":"trace-7th-0001","method":"POST","path":"/api/cards","status":202,"ms":34}
5. Fluentd — JSON 을 펼치고, ingress 로그를 쪼갠다#
apps/logging/k8s/config/forwarder.conf 를 고친다. 바뀐 곳은 넷이다.
① JSON 줄을 필드로 펼친다#
<filter kube.**>
  @type parser
  key_name message
  reserve_data true
  reserve_time true
  remove_key_name_field true
  emit_invalid_record_to_error false
  <parse>
    @type json
  </parse>
</filter>
reserve_data true— 펼친 필드 옆에 원래 필드(파드 정보 등)를 남긴다.remove_key_name_field true— 펼치고 나면 원문message는 지운다. 같은 내용이 두 번 저장되지 않는다.emit_invalid_record_to_error false— JSON 이 아닌 줄(RabbitMQ 로그, gunicorn 기동 메시지)은 오류로 버리지 않고 그대로 둔다.
② /healthz 걸러내기를 두 모양 다#
주의
앞 편에서
/healthz를"GET /healthz "라는 글자로 걸렀다. 접근 로그를 JSON 으로 바꾸면 그 줄은
"path":"/healthz"모양이 되어 옛 패턴에 안 걸린다. 오류도 안 나고 조용히 소음이 되살아난다.
둘 다 거른다. 그리고 JSON 으로 펼치기 전에 거른다 — 펼치고 나면message가 없어진다.
<filter kube.**>
  @type grep
  <exclude>
    key message
    pattern /"GET /healthz |"path":"/healthz"/
  </exclude>
</filter>
③ ingress 접근 로그를 읽어 칸으로 쪼갠다#
요청 번호가 처음 생기는 곳이니 이것도 모은다. 컨트롤러 로그 파일만 따로 읽는다.
<source>
  @type tail
  @id in_tail_ingress
  path /var/log/containers/*_ingress-nginx_controller-*.log
  pos_file /var/lib/fluentd/ingress.pos
  tag ingress.*
  read_from_head false
  refresh_interval 5
  <parse>
    @type cri
  </parse>
</source>
nginx 접근 로그는 JSON 이 아니라 칸이 공백으로 이어진 글자다. 정규식으로 쪼갠다.
맨 끝 칸이 request_id 다.
<filter ingress.**>
  @type parser
  key_name message
  reserve_data true
  reserve_time true
  remove_key_name_field true
  emit_invalid_record_to_error false
  <parse>
    @type regexp
    expression /^(?<remote_addr>S+) - (?<remote_user>S+) [(?<time_local>[^]]+)] "(?<method>S+) (?<path>S+) (?<protocol>[^"]+)" (?<status>d+) (?<bytes>d+) "(?<referer>[^"]*)" "(?<user_agent>[^"]*)" (?<request_length>d+) (?<request_time>[d.]+) [(?<upstream_name>[^]]*)] [(?<upstream_alt>[^]]*)] (?<upstream_addr>S+) (?<upstream_length>S+) (?<upstream_time>S+) (?<upstream_status>S+) (?<request_id>S+)$/
  </parse>
</filter>

<filter ingress.**>
  @type grep
  <regexp>
    key path
    pattern /^/linkcard/
  </regexp>
</filter>

<filter ingress.**>
  @type record_transformer
  <record>
    event http.ingress
  </record>
</filter>
두 번째 필터는 linkcard 로 가는 요청만 남긴다. 쪼개지지 않은 줄(컨트롤러 자체 메시지)은 path 가 없어서
여기서 함께 빠진다. 세 번째는 앱 로그와 같은 모양으로 찾을 수 있게 사건 이름을 붙인다.
팁
정규식은 배포하기 전에 실제 로그 줄로 먼저 맞춰 본다. 이 식은 컨트롤러 로그에서 뽑은 실제 줄 6개에
넣어 6개 모두 맞는 걸 확인하고 넣었다. 틀린 정규식은 오류를 내지 않는다.emit_invalid_record_to_error false
때문에 조용히 안 쪼개진 채로 흘러간다.
나머지 필터(파드 정보 붙이기, 필드 정리)의 태그도 kube.** 에서 {kube,ingress}.** 로 넓힌다.
④ forwarder 를 control-plane 에도 띄운다#
0단계에서 forwarder 는 워커 노드 둘에만 있었다. 그런데 ingress 컨트롤러는 control-plane 에 있다.
(클러스터 구성 편에서 80·443 포트를 control-plane 에만 열었기 때문이다.) control-plane
에는 "일반 파드는 오지 마라" 는 taint 가 있어서, DaemonSet 이라도 허락을 받아야 뜬다.
# apps/logging/k8s/30-forwarder.yaml
    spec:
      serviceAccountName: fluentd
      tolerations:
        - key: node-role.kubernetes.io/control-plane
          operator: Exists
          effect: NoSchedule
집계기 설정은 받을 태그만 적는다. <match **> 로 두면 Fluentd 자기 내부 로그(fluent.*)까지
잡는다는 경고가 뜬다.
<match {kube,ingress}.**>
  @type stdout
  @id out_stdout
</match>
6. gitops 로 배포한다#
이미지를 새로 만들어 kind 에 싣고, 매니페스트의 태그를 올린다.
docker build -t linkcard-web:v9 apps/linkcard/web
docker build -t linkcard-worker:v3 apps/linkcard/worker
kind load docker-image linkcard-web:v9 linkcard-worker:v3 --name lab
20-web.yaml 은 linkcard-web:v9, 30-worker.yaml 은 linkcard-worker:v3 로 바꾼다. 그리고 커밋·푸시한다.
git add -A
git commit -m "요청 번호로 끝까지 따라가기 — X-Request-ID → correlation_id, JSON 로그"
git push origin main
앱 두 개(linkcard, logging)가 모두 방금 푸시한 커밋으로 맞춰졌는지 본다.
SHA=$(git rev-parse HEAD)
kubectl get application -n argocd linkcard logging
  -o custom-columns=NAME:.metadata.name,REV:.status.sync.revision,HEALTH:.status.health.status
실제로 지켜본 흐름이다.
  +0초  linkcard=4a3757c/Healthy  logging=4a3757c/Healthy
  +4초  linkcard=a78e036/Progressing  logging=a78e036/Progressing
  +16초  linkcard=a78e036/Healthy  logging=a78e036/Progressing
+29초 linkcard=a78e036/Healthy logging=a78e036/Healthy참고
ArgoCD 편에서 본 것처럼, "동기화 성공" 만 보면 이전 동기화의 성공을 읽을 수 있다.
sync.revision이 방금 푸시한 커밋 번호와 같은지로 판단한다.
forwarder 가 세 노드 모두에 떴다.
kubectl get pods -n logging -l app=fluentd-forwarder
  -o jsonpath='{range .items[*]}{.metadata.name}  {.spec.nodeName}{"n"}{end}'
fluentd-forwarder-7b9rq lab-worker2
fluentd-forwarder-ccbt8 lab-control-plane
fluentd-forwarder-jtz7g lab-worker7. 확인 — 번호 하나로 끝까지 따라간다#
재시도가 붙어야 따라갈 게 많다. 늘 503 을 주는 주소를 번호를 정해 넣는다.
curl -s -X POST http://localhost/linkcard/api/cards
  -H 'Content-Type: application/json'
  -H 'X-Request-ID: trace-7th-0001'
  -d '{"url":"https://mock.httpstatus.io/503"}'
{"accept_elapsed": 0.032, "job_id": "5b485a33fdf3", "ok": true, "request_id": "trace-7th-0001", "status": "queued"}응답에 번호가 돌아온다. 작업이 끝날 때까지 기다린 뒤, 집계기에 모인 로그를 request_id 칸 하나로만
골라 시간순으로 정렬했다. job_id 로는 찾지 않았다.
시각           컨테이너    사건                  내용
23:36:31.853  worker      job.start            attempt=1
23:36:31.861  web         job.queued
23:36:31.861  web         http.access          status=202 method=POST path=/api/cards ms=34
23:36:31.863  controller  http.ingress         status=202 method=POST path=/linkcard/api/cards request_time=0.040
23:36:32.261  web         result.retrying      attempt=1 total_wait=0.43
23:36:32.262  web         http.access          status=200 method=POST path=/internal/result ms=1
23:36:32.262  worker      job.retry_scheduled  attempt=1 delay=5 code=http_503
23:36:37.265  worker      job.start            attempt=2
23:36:37.757  web         result.retrying      attempt=2 total_wait=5.93
23:36:37.757  web         http.access          status=200 method=POST path=/internal/result ms=2
23:36:37.758  worker      job.retry_scheduled  attempt=2 delay=15 code=http_503
23:36:52.760  worker      job.start            attempt=3
23:36:53.279  web         result.failed        attempt=3 total_wait=21.45
23:36:53.279  web         http.access          status=200 method=POST path=/internal/result ms=1
23:36:53.279  worker      job.dead_lettered    attempt=3 code=http_503
15줄. 0단계에서 번호가 든 줄이 0줄이던 것과 비교된다. 세어 보면 이렇다.
| 확인한 것 | 결과 |
|---|---|
| 컨테이너별 줄 수 | web 8 · worker 6 · ingress controller 1 |
| 이 번호를 남긴 파드 | 5개 (ingress 1 · web 2 · worker 2) |
worker job.start 의 attempt |
1, 2, 3 — 재시도에도 번호가 끊기지 않았다 |
| 접수부터 DLQ 까지 | 21.45초 (5초 + 15초 대기 포함) |
집계기에 모인 한 줄은 이렇게 생겼다. 글자가 아니라 칸이다.
{
  "stream": "stdout",
  "time": "2026-09-14T23:36:32.262563305Z",
  "event": "job.retry_scheduled",
  "request_id": "trace-7th-0001",
  "job_id": "5b485a33fdf3",
  "attempt": 1,
  "delay": 5,
  "code": "http_503",
  "error": "HTTP 503",
  "elapsed": 0.4,
  "app": "linkcard-worker",
  "pod": "linkcard-worker-65758f754c-6mwlk",
  "container": "worker",
  "node": "lab-worker"
}docker, kubernetes, 원문 message 칸은 남지 않았다. 집계기 전체를 세어 봐도 0건이었다.
/healthz 줄도 0건이다.
표를 보면 보이는 것 셋#
① 시각이 "일어난 순서" 가 아니다#
첫 줄을 보자. worker 의 job.start(31.853) 가 web 의 job.queued(31.861) 보다 먼저 찍혔다.
작업은 web 이 넣어야 worker 가 받는데 말이다.
코드를 보면 이유가 있다. web 은 큐에 넣고, Redis 에 저장한 다음에 job.queued 를 찍는다.
그 사이에 worker 는 이미 메시지를 받아 job.start 를 찍었다. ingress 줄(31.863)이 가장 늦은 것도
같은 이치다. nginx 는 응답을 다 보낸 뒤에 접근 로그를 쓴다.
참고
로그의 시각은 그 줄을 쓴 순간이다. 사건이 시작된 순간이 아니다. 몇 밀리초 차이로 순서가 뒤집히는 건
흔하다. "누가 먼저였나" 를 따질 때는 시각보다 attempt 같은 순서 번호를 믿는다.
도착 순서도 믿을 게 못 된다. 집계기에 도착한 순서로 보면 앞 줄보다 이른 시각이 온 경우가 4번 있었다.
노드 셋의 forwarder 가 제각각 2초마다 보내기 때문이다. 앞 편과 같은 결론이다 —
반드시 시간으로 다시 정렬한다.
② 폴링 요청은 번호가 모두 다르다#
화면은 결과가 나올 때까지 0.5초마다 GET /api/cards/5b485a33fdf3 를 부른다. 그 접근 로그를 따로 셌다.
| 확인한 것 | 결과 |
|---|---|
| 이 작업을 조회한 web 접근 로그 | 43건 |
| 그중 서로 다른 request_id | 43개 |
그중 trace-7th-0001 |
0건 |
당연하다. 조회는 각각 새 HTTP 요청이라 ingress 가 매번 새 번호를 만든다. 이 43줄은 경로 속
job_id 로만 작업과 이어진다.
그래서 번호는 두 개가 필요하다.
- request_id — "이 요청 하나에서 무슨 일이 있었나". 요청이 끝나면 끝난다.
- job_id — "이 작업에 대해 누가 무엇을 했나". 여러 요청에 걸쳐 산다.
두 칸이 한 줄에 같이 있으니(job.queued 에 둘 다 있다) 어느 쪽에서든 다른 쪽으로 건너갈 수 있다.
③ 진짜 사건은 얼마 안 된다#
같은 시점에 집계기에 모인 줄을 사건 이름별로 셌다.
| 사건 | 줄 수 |
|---|---|
| (JSON 이 아닌 글자 로그) | 47 |
| http.access | 47 |
| http.ingress | 44 |
| job.start | 3 |
| result.retrying | 2 |
| job.retry_scheduled | 2 |
| job.queued | 1 |
| result.failed | 1 |
| job.dead_lettered | 1 |
작업의 사건은 10줄이다. 나머지는 접근 로그와 RabbitMQ · Redis 의 글자 로그다. 이전에는 이걸 가를
방법이 없었다. 이제는 event 칸 하나로 가른다. 접근 로그를 버리지 않은 건 쓸모가 있어서다 —
ms 칸으로 느린 요청을 찾을 수 있다.
아직 불편한 것#
번호로 이을 수는 있게 됐다. 그런데 위 표들은 전부 집계기의 표준 출력을 긁어 와 파이썬으로 세어서 만들었다.
- 집계기가 재시작하면 모은 로그가 사라진다. 앞 편에서 581건이 그렇게 날아갔다.
- "request_id 로 찾기", "시간순 정렬", "사건별로 세기" 를 할 때마다 스크립트를 짜야 한다.
- 칸의 자료형이 섞여 있다. web 접근 로그의
status는 숫자202인데, 정규식으로 쪼갠 ingress 로그의status는 글자"202"다. 문자열로 뒤질 때는 몰랐는데, 칸으로 검색하고 집계하기 시작하면 문제가 된다.
모두 보관하고 검색하는 곳이 없어서 생기는 일이다. 다음 편에서 집계기의 출력을 OpenSearch 로 바꾼다.
정리#
- 요청 번호는 가장 앞단이 만들고, 뒤는 넘기기만 한다. ingress-nginx 는 이미
X-Request-ID를 만들어 넘기고 있었다. 바꾸기 전 작업 로그 5줄 중 번호가 든 줄은 0줄이었다. - HTTP 가 아닌 구간은 메시지에 싣는다. RabbitMQ 는
correlation_id칸에 넣는다. - 다시 발행할 때 속성은 따라오지 않는다. 재시도·DLQ 로 넣을 때
correlation_id를 다시 적어야 두 번째 시도부터 번호가 끊기지 않는다. 적고 나니 attempt 1·2·3 이 한 번호로 이어졌다. - 로그는 사건 이름이 붙은 JSON 한 줄로.
app.logger는 gunicorn 머리말 때문에 JSON 이 깨진다. 로그 모양을 바꾸면 옛 필터가 조용히 무력해진다 (/healthz). - 로그 시각은 쓴 순간이다. worker 의 시작이 web 의 접수보다 먼저 찍혔다. 순서는 attempt 같은 번호로 판단한다.
- request_id 와 job_id 는 둘 다 필요하다. 폴링 43건은 번호가 43개 모두 달랐고, job_id 로만 이어졌다.

댓글