앞 편에서 재시도를 만들었다. 그 과정을 확인하느라 이런 명령을 수도 없이 쳤다.
kubectl logs -n linkcard linkcard-worker-7b9cb46788-8jm6p
kubectl logs -n linkcard linkcard-worker-7b9cb46788-df6xk
kubectl logs -n linkcard -l app=linkcard-web --prefix
작업 하나가 어떻게 흘러갔는지 보려면 파드마다 로그를 열어 봐야 했다. 재시도는 다른 워커가 받기도 하니
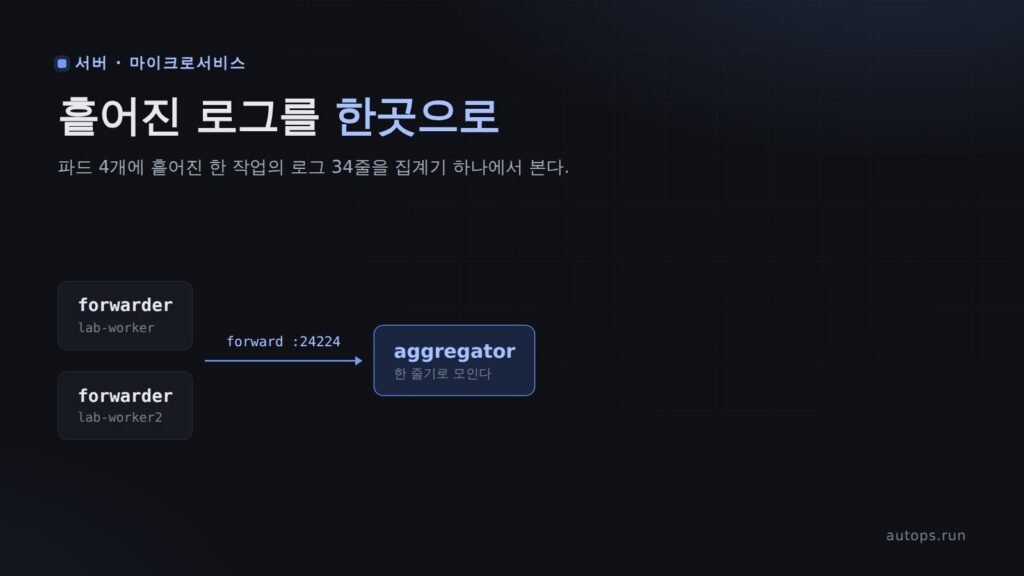
어느 파드를 봐야 할지부터 헷갈린다. 이번 편은 흩어진 로그를 한곳에 모은다.
먼저 겪는 문제 셋#
모으기 전에 지금 상태가 얼마나 불편한지 재 봤다.
① 파드를 지우면 로그를 볼 방법이 없다#
워커 파드 하나를 지웠다.
kubectl delete pod -n linkcard linkcard-worker-7b9cb46788-lwfn9
kubectl logs -n linkcard linkcard-worker-7b9cb46788-lwfn9
error: error from server (NotFound): pods "linkcard-worker-7b9cb46788-lwfn9" not found in namespace "linkcard"kubectl logs 는 살아 있는 파드의 로그만 보여 준다. 방금까지 이 파드가 처리하던 작업의 기록은
이제 kubectl 로 볼 수 없다. 장애가 나서 파드가 재시작됐을 때 가장 보고 싶은 게 바로 그 로그인데 말이다.
참고
지운 직후 노드 안의 로그 디렉터리(
/var/log/pods/...)는 아직 남아 있었다. 하지만 노드에 직접
들어가지 않는 한 볼 수 없고, 쿠버네티스가 정리하면 그마저 사라진다.
② 로그의 절반 이상이 쓸모없는 줄이다#
web 로그 최근 733줄을 세어 봤다.
전체 733줄 중 /healthz 417줄 (56.9%)172.18.0.3 - - [14/Sep/2026:23:09:07 +0000] "GET /healthz HTTP/1.1" 200 28 "-" "kube-probe/1.37"
172.18.0.3 - - [14/Sep/2026:23:09:08 +0000] "GET /healthz HTTP/1.1" 200 28 "-" "kube-probe/1.37"쿠버네티스가 파드가 살아 있는지 몇 초마다 확인하는 요청(kube-probe)이다.
2편에서 넣은 readinessProbe·livenessProbe 가 두드리는 것이다.
정작 봐야 할 줄이 이 사이에 파묻힌다.
③ 내가 남긴 줄이 없다#
web 은 작업을 접수할 때 이렇게 기록하게 짜 두었다.
app.logger.info("job queued id=%s url=%s", job_id, url)그런데 로그를 뒤져 보니 이 줄이 0개였다.
'job queued' / 'job done' 줄 수: 0주의
gunicorn 으로 띄운 Flask 앱은
app.logger.info가 아무 데도 안 찍힌다. Flask 로거는
따로 설정해 주지 않으면 WARNING 이상만 내보낸다. 개발 서버에서는 보이다가 배포하면
사라져서, "로그를 넣었는데 왜 안 보이지" 하고 헤매기 좋다.
gunicorn 의 로거에 붙여 같은 곳, 같은 수준(INFO)으로 내보내게 고쳤다.
app = Flask(__name__)

import logging
_gunicorn_logger = logging.getLogger("gunicorn.error")
if _gunicorn_logger.handlers:
    app.logger.handlers = _gunicorn_logger.handlers
    app.logger.setLevel(_gunicorn_logger.level)
무엇을 만드나#
 lab-worker 노드                       lab-worker2 노드
┌──────────────────────────┐          ┌──────────────────────────┐
│ web · worker · rabbitmq  │          │ web · worker             │
│        │ 로그 파일        │          │        │ 로그 파일        │
│        ▼                 │          │        ▼                 │
│   forwarder ─────────────┼──┐   ┌───┼── forwarder             │
└──────────────────────────┘  │   │   └──────────────────────────┘
                              ▼   ▼
aggregator ← 모든 로그가 모이는 한곳| 역할 | 하는 일 | 쿠버네티스 종류 |
|---|---|---|
| forwarder | 자기 노드의 로그 파일을 읽어 넘긴다 | DaemonSet — 노드마다 하나 |
| aggregator | forwarder 들이 보낸 로그를 받아 한곳에 모은다 | Deployment — 하나 |
참고
DaemonSet 이 무엇인가. Deployment 는 "파드를 몇 개 띄울지" 를 정한다. DaemonSet 은
"노드마다 하나씩" 띄운다. 로그 파일은 각 노드의 디스크에 있으니, 파드 수가 아니라
노드마다 반드시 하나가 있어야 한다. 노드가 늘면 알아서 하나 더 뜬다.
Fluentd 자체가 처음이라면 Fluentd 처음 배우기를 먼저 보는 편이 낫다.
설정 파일의 source · filter · match 구조를 거기서 짚는다.
1. 로그는 노드 어디에 있나#
컨테이너가 표준 출력으로 내보낸 로그는 노드의 파일로 쌓인다. kind 는 노드가 도커 컨테이너라
직접 들어가 볼 수 있다.
docker exec lab-worker ls /var/log/containers/ | grep linkcardlinkcard-web-569c4dd599-5vtqm_linkcard_web-fb312fa02de8....log
linkcard-worker-7b9cb46788-lwfn9_linkcard_worker-8151bfaafebd....log
rabbitmq-0_linkcard_rabbitmq-8b4cc5f03462....log
redis-0_linkcard_redis-7d1486694abf....log파일 이름이 <파드>_<네임스페이스>_<컨테이너>-<id>.log 다. 이름만 보고도 어느 네임스페이스
것인지 고를 수 있다. 이 파일들은 실제로는 다른 곳을 가리키는 링크다.
docker exec lab-worker readlink -f /var/log/containers/linkcard-worker-...log/var/log/pods/linkcard_linkcard-worker-7b9cb46788-lwfn9_2ee7c52c-.../worker/0.log안에 든 한 줄은 이렇게 생겼다.
2026-09-14T23:03:55.233830344Z stdout F [worker] 시작 job=97b37485ddf3 attempt=3/3 url=http://10.255.255.1/| 조각 | 뜻 |
|---|---|
2026-09-14T23:03:55.233830344Z |
기록된 시각 |
stdout |
표준 출력인지 표준 에러인지 |
F |
한 줄이 끝났는지(F) 이어지는지(P) |
| 나머지 | 앱이 실제로 찍은 내용 |
이 모양을 CRI 형식이라고 부른다. containerd 가 이렇게 남긴다. 기억해 두자. 바로 뒤에서 쓴다.
2. 이미지 고르기#
Fluentd 는 fluent/fluentd-kubernetes-daemonset 이미지를 쓴다. 쿠버네티스에서 쓸 플러그인이
미리 들어 있다. 맥이 arm64 라 두 아키텍처를 다 지원하는 태그를 골랐다.
v1.19-debian-opensearch-1        amd64,arm64
v1-debian-opensearch             amd64
v1-debian-opensearch 처럼 amd64 만 있는 태그가 섞여 있으니 주의한다. 이미지 안을 들여다보면
필요한 플러그인이 다 있다.
fluentd : fluentd 1.19.3
fluent-plugin-kubernetes_metadata_filter (3.8.0)
fluent-plugin-opensearch (1.1.6)
fluent-plugin-parser-cri (0.1.1)
그런데 이미지의 기본 설정을 보면 이렇다.
@type "#{ENV['FLUENT_CONTAINER_TAIL_PARSER_TYPE'] || 'json'}"주의
기본 파서가
json이다. 도커 엔진 시절에는 컨테이너 로그가 JSON 한 줄씩이었다. 하지만
요즘 쿠버네티스는 containerd 를 쓰고, 로그는 앞에서 본 CRI 형식이다. 기본값 그대로 두면
로그를 한 줄도 제대로 읽지 못한다.cri로 바꿔야 한다.
이 기본 설정에는 OpenSearch 로 보내는 부분까지 들어 있어서, 이번에는 쓰지 않고 설정 파일을
직접 쓴다.
3. forwarder 설정 — 다섯 단계#
# ① 읽는다
<source>
  @type tail
  path /var/log/containers/*_linkcard_*.log
  pos_file /var/lib/fluentd/linkcard.pos
  tag kube.*
  read_from_head true
  <parse>
    @type cri
  </parse>
</source>path— linkcard 네임스페이스 파일만 고른다. 파일 이름 규칙 덕분이다.pos_file— 어디까지 읽었는지 적어 두는 파일. 뒤에서 이게 왜 중요한지 재 본다.<parse> @type cri— 앞에서 본 CRI 형식으로 쪼갠다.
# ② 어느 파드의 로그인지 붙인다
<filter kube.**>
  @type kubernetes_metadata
  skip_labels false
  skip_container_metadata true
  skip_master_url true
  skip_namespace_metadata true
</filter>
파일 이름에서 파드 이름을 뽑고, 쿠버네티스 API 에 물어 라벨까지 가져온다. app=linkcard-worker
같은 라벨로 나중에 골라 볼 수 있다.
# ③ 쓸모없는 줄은 버린다
<filter kube.**>
  @type grep
  <exclude>
    key message
    pattern /"GET /healthz /
  </exclude>
</filter>
로그의 56.9% 를 차지하던 /healthz 를 여기서 버린다. 앱을 고치지 않고 수집 단계에서 거른다.
# ④ 읽기 좋게 펼친다
<filter kube.**>
  @type record_transformer
  enable_ruby true
  <record>
    app       ${record.dig("kubernetes", "labels", "app")}
    pod       ${record.dig("kubernetes", "pod_name")}
    container ${record.dig("kubernetes", "container_name")}
    node      ${record.dig("kubernetes", "host")}
  </record>
  remove_keys kubernetes,logtag,docker
</filter>
쿠버네티스 정보는 여러 겹으로 중첩돼 있다. 자주 볼 것만 위로 꺼내고 나머지는 지운다.
# ⑤ 집계기로 넘긴다
<match kube.**>
  @type forward
  <server>
    host fluentd-aggregator.logging.svc.cluster.local
    port 24224
  </server>
  <buffer>
    @type file
    path /var/lib/fluentd/buffer
    flush_interval 2s
    retry_forever true
  </buffer>
</match>
집계기가 잠깐 죽어 있어도 버퍼 파일에 쌓아 두었다가 다시 보낸다.
4. aggregator 설정#
받아서 내보내기만 한다. 지금은 표준 출력이다.
<source>
  @type forward
  bind 0.0.0.0
  port 24224
</source>

<match kube.**>
  @type stdout
</match>
5. 배포하기 전에 문법부터 본다#
설정을 이미지 안에서 미리 검사할 수 있다. --dry-run 은 설정을 읽기만 하고 실제로 돌지는 않는다.
docker run --rm -v "$PWD/config:/cfg:ro" --entrypoint fluentd
  fluent/fluentd-kubernetes-daemonset:v1.19-debian-opensearch-1
  --dry-run -c /cfg/aggregator.conf
2026-09-14 23:12:43 +0000 [info]: finished dry run modeforwarder 는 이렇게 끝났다.
[info]: [out_forward] adding forwarding server 'fluentd-aggregator.logging.svc.cluster.local:24224'
[error]: unexpected error error_class=Socket::ResolutionError error="getaddrinfo: Temporary failure in name resolution"
설정은 다 읽었고, 집계기 주소를 찾다가 실패했다. 맥의 도커는 클러스터 밖이라 클러스터 안의
서비스 이름을 풀 수 없으니 당연한 결과다. 설정 문법이 틀렸다면 그 앞에서 멈췄을 것이다.
6. 매니페스트#
권한 — 파드 정보를 읽을 수만 있게#
②단계의 메타데이터 필터가 쿠버네티스 API 에 묻기 때문에 권한이 필요하다. 읽기만 준다.
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: fluentd-read-pods
rules:
  - apiGroups: [""]
    resources: [pods, namespaces]
    verbs: [get, list, watch]
forwarder — DaemonSet#
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: fluentd-forwarder
  namespace: logging
spec:
  selector:
    matchLabels: { app: fluentd-forwarder }
  template:
    metadata:
      labels: { app: fluentd-forwarder }
    spec:
      serviceAccountName: fluentd
      containers:
        - name: fluentd
          image: fluent/fluentd-kubernetes-daemonset:v1.19-debian-opensearch-1
          command: ["fluentd", "-c", "/fluentd/etc/custom/fluent.conf"]
          env:
            - name: K8S_NODE_NAME
              valueFrom:
                fieldRef: { fieldPath: spec.nodeName }
          volumeMounts:
            - { name: varlog, mountPath: /var/log, readOnly: true }
            - { name: state,  mountPath: /var/lib/fluentd }
            - { name: config, mountPath: /fluentd/etc/custom }
      volumes:
        - name: varlog
          hostPath: { path: /var/log }
        - name: state
          hostPath: { path: /var/lib/fluentd, type: DirectoryOrCreate }
        - name: config
          configMap: { name: fluentd-forwarder-config }
세 가지를 짚는다.
hostPath: /var/log— 노드의 로그 디렉터리를 파드 안에서 그대로 들여다본다.readOnly로 건다.hostPath: /var/lib/fluentd— 읽은 위치와 버퍼를 노드 디스크에 둔다.emptyDir로 두면 파드가 재시작될 때 함께 지워진다.K8S_NODE_NAME— 메타데이터 필터가 "내 노드의 파드" 만 지켜보게 해 API 부담을 줄인다.
참고
이 DaemonSet 은 control-plane 노드에는 뜨지 않는다. control-plane 에는 "일반 파드는 오지 마라"
는 taint 가 걸려 있고, 여기엔 그걸 견디는 toleration 을 주지 않았다. linkcard 파드는 워커에만
뜨니 이번에는 그걸로 충분하다.
설정 파일은 kustomize 로 ConfigMap 을 만든다#
configMapGenerator:
  - name: fluentd-forwarder-config
    files:
      - fluent.conf=config/forwarder.conf
  - name: fluentd-aggregator-config
    files:
      - fluent.conf=config/aggregator.conf
이렇게 만들면 ConfigMap 이름 끝에 설정 내용의 해시가 붙는다.
name: fluentd-aggregator-config-c6ch7f7ct8
name: fluentd-forwarder-config-cbdg6ch2bd
설정을 고치면 해시가 바뀌고, 그 ConfigMap 을 쓰는 파드가 알아서 다시 뜬다. 설정만 바꾸고 파드는
옛 설정으로 계속 도는 흔한 실수를 막아 준다.
팁
처음에는 두 설정을 ConfigMap 하나에 넣었다. 그러면 forwarder 설정만 고쳐도 해시가 바뀌어
상관없는 aggregator 까지 다시 뜬다. 그래서 둘로 나눴다.
7. ArgoCD 로 배포한다#
git 에 올리고 ArgoCD Application 을 하나 더 만든다. linkcard 앱과 따로 둔다. 앱을 지웠다 다시
깔아도 로그 수집은 계속 돌아야 하기 때문이다.
앞 편에서 동기화 확인 스크립트가 직전 동기화 결과를 읽는 실수를 했다.
이번엔 리비전이 내가 올린 커밋 해시와 같아질 때까지 기다렸다.
두 앱의 리비전이 7a77e7a 이 되고 Healthy 가 될 때까지
+0초   linkcard=cbf571b/Healthy      logging=/
+5초   linkcard=7a77e7a/Progressing  logging=7a77e7a/Progressing
+26초  linkcard=7a77e7a/Healthy      logging=7a77e7a/Progressing
+31초  linkcard=7a77e7a/Healthy      logging=7a77e7a/Healthy
fluentd-aggregator-6bfcbc6d56-vpclc 1/1 Running lab-worker2
fluentd-forwarder-v5g99 1/1 Running lab-worker2
fluentd-forwarder-zwf94 1/1 Running lab-workerforwarder 는 워커 노드 두 곳에만 떴다.
8. 확인 — 정말 한곳에 모였나#
집계기 로그를 열어 세어 봤다.
레코드 522건
  app=rabbitmq           container=rabbitmq  414건
  app=redis              container=redis     92건
  app=linkcard-web       container=web       12건
  app=linkcard-worker    container=worker    4건
집계기에 들어온 /healthz 줄: 0건
같은 시간 동안 web 원본에는 /healthz 가 28줄 있었다. 집계기로 오기 전에 전부 버려졌다.
참고
rabbitmq 가 가장 많은 건
read_from_head true때문이다. 처음 뜰 때 파일을 맨 앞부터 읽어서,
그동안 쌓여 있던 rabbitmq 기동 로그까지 한꺼번에 들어왔다.
레코드 한 건은 이렇게 생겼다.
stream    = stdout
message   = [worker] 재시도 예약 job=97b37485ddf3 attempt=2 → 15초 뒤 error=가져오지 못했습니다: ...
time      = 2026-09-14T23:03:40.23652117Z
app       = linkcard-worker
pod       = linkcard-worker-7b9cb46788-zqmth
container = worker
node      = lab-worker2
어느 앱의, 어느 파드의, 어느 노드의 로그인지가 붙어 있다.
작업 하나를 한곳에서 따라간다#
재시도가 붙는 503 작업을 하나 넣고, 집계기 한 곳에서 job_id 로 찾았다.
job=ebc49322e05a 로 찾은 줄: 34건

23:16:42  worker zqmth  시작 job=ebc49322e05a attempt=1/3 url=https://mock.httpstatus.io/503
23:16:42  worker zqmth  재시도 예약 job=ebc49322e05a attempt=1 → 5초 뒤 error=HTTP 503
23:16:43  web    mrk7r  10.244.180.131 - - [14/Sep/2026:23:16:43 +0000] "GET /api/cards/ebc49322e05a HTTP/1.1" 200
23:16:44  web    mrk7r  10.244.180.131 - - [14/Sep/2026:23:16:44 +0000] "GET /api/cards/ebc49322e05a HTTP/1.1" 200
23:16:42  web    7bv9h  job queued id=ebc49322e05a url=https://mock.httpstatus.io/503 in=0.029s
23:16:42  web    7bv9h  job done id=ebc49322e05a ok=False wait=0.42s
23:16:47  worker 7d65z  시작 job=ebc49322e05a attempt=2/3 url=https://mock.httpstatus.io/503
23:16:48  worker 7d65z  재시도 예약 job=ebc49322e05a attempt=2 → 15초 뒤 error=HTTP 503
23:16:48  web    7bv9h  job done id=ebc49322e05a ok=False wait=5.88s
   ⋮
23:17:03  web    mrk7r  job done id=ebc49322e05a ok=False wait=21.50s
23:17:03  worker zqmth  시작 job=ebc49322e05a attempt=3/3 url=https://mock.httpstatus.io/503
23:17:03  worker zqmth  포기 job=ebc49322e05a attempt=3 → DLQ

이 작업 하나를 남긴 파드: 4개  →  7bv9h, mrk7r, 7d65z, zqmth
작업 하나가 파드 4개에 로그를 남겼다. web 두 개, worker 두 개. 전에는 kubectl logs 를 네 번
쳐서 머릿속으로 이어 붙여야 했다. 이제 한곳에서 찾으면 된다. 고쳐 둔 덕에 web 의 job queued
1줄과 job done 3줄도 보인다.
지운 파드의 로그가 남는가#
이 작업의 두 번째 시도를 처리한 워커 7d65z 를 지웠다.
kubectl logs  : error: error from server (NotFound): pods "linkcard-worker-7b9cb46788-7d65z" not found
집계기에 남은 그 파드의 줄: 3건 (지우기 전 3건)
  │ 시작 job=ebc49322e05a attempt=2/3 url=https://mock.httpstatus.io/503
  │ 재시도 예약 job=ebc49322e05a attempt=2 → 15초 뒤 error=HTTP 503
파드는 사라졌지만 로그는 남았다. 처음에 겪은 ①번 문제가 풀렸다.
모으고 나서 새로 보인 것#
한곳에 모으자 흩어져 있을 때는 안 보이던 것들이 보였다.
① 도착 순서가 시간 순서가 아니다. 위 출력을 다시 보면 23:16:43, 23:16:44 줄 뒤에
23:16:42 줄이 온다. job done wait=21.50s 도 워커의 세 번째 시작 보다 먼저 찍혔다. 노드마다
forwarder 가 따로 2초씩 모아 보내니, 먼저 도착한 쪽이 먼저 찍힌다.
주의
모인 로그를 위에서부터 읽으면 순서를 오해한다. 원인과 결과가 뒤바뀌어 보일 수 있다.
반드시time필드로 다시 정렬해서 봐야 한다. 표준 출력으로는 그게 안 된다.
② 이번엔 폴링이 소음이다. 34줄 중 대부분이 GET /api/cards/<id> 다. 화면이 0.5초마다 결과를
물어보는 요청이다. /healthz 를 걸렀더니 그다음 소음이 드러났다.
③ 중간 보고에도 job done 이라고 찍힌다. job done ... wait=0.42s 는 사실 끝난 게 아니라
"재시도하겠다" 는 중간 보고다. 로그 문구가 실제 상태와 어긋나 있다.
②와 ③은 로그를 글자로만 남기고 있어서 생긴다. 다음 편에서 로그에 구조를 준다.
9. forwarder 가 재시작되면 처음부터 다시 읽을까#
read_from_head true 는 "파일을 맨 앞부터 읽어라" 는 뜻이다. 그럼 forwarder 가 재시작될 때마다
이미 보낸 로그를 또 보내는 것 아닐까. 재 봤다.
설정을 조금 고쳐 커밋했다(docker 필드를 지우도록). ConfigMap 해시가 바뀌어 forwarder 와 aggregator 가
모두 다시 떴다.
[전] 집계기 vpclc: 전체 581건  rabbitmq 422 · redis 102 · web 44 · worker 13
     job=ebc49322e05a 줄: 34건

[후] forwarder 이름: v5g99 → gvj9c, zwf94 → d4r9p   (둘 다 새로 떴다)
     집계기 jfg2c: 전체 0건  rabbitmq 0 · redis 0 · web 0 · worker 0
     job=ebc49322e05a 줄: 0건
옛 로그를 한 줄도 다시 보내지 않았다. 파일을 맨 앞부터 읽는 설정인데도 그렇다.
그런데 0건이면 "forwarder 가 고장 나서 아무것도 안 보내는 것" 일 수도 있다. 그래서 대조 확인을 했다.
새 작업을 하나 넣었다.
집계기 jfg2c: 전체 16건  rabbitmq 4 · redis 5 · web 5 · worker 2
job=28fe516dcb2f 줄: 5건  (docker 필드 남은 레코드 0건)
새 로그는 들어온다. 옛 로그만 안 온 것이다. 고친 설정대로 docker 필드도 사라졌다.
비결은 pos_file 이다. 노드에서 열어 보면 파일마다 어디까지 읽었는지가 적혀 있다.
docker exec lab-worker2 cat /var/lib/fluentd/linkcard.pos/var/log/containers/linkcard-web-8588c54c74-mrk7r_linkcard_web-bb865c7....log 0000000000002a4f 0000000000036849
/var/log/containers/linkcard-worker-7b9cb46788-zqmth_linkcard_worker-4....log 000000000000045d 00000000000321e0가운데가 읽은 위치, 오른쪽이 파일의 inode(파일 고유 번호)다. 재시작한 forwarder 는 이걸 보고
이어서 읽는다. read_from_head 는 pos 기록이 없는 새 파일에만 적용된다.
주의
이 파일을
emptyDir에 두면 파드가 재시작될 때 함께 지워진다. 그러면read_from_head true가
그대로 먹혀 모든 로그를 처음부터 다시 보낸다. 로그가 통째로 중복된다. 반드시 노드 디스크(hostPath)에 둔다.
10. 그런데 581건은 어디 갔나#
위 실험에서 넘어간 게 하나 있다. 집계기가 vpclc 에서 jfg2c 로 바뀌었다. 옛 집계기에 쌓여 있던
581건은 어떻게 됐을까.
kubectl logs -n logging fluentd-aggregator-6bfcbc6d56-vpclcerror: error from server (NotFound): pods "fluentd-aggregator-6bfcbc6d56-vpclc" not found in namespace "logging"사라졌다. 집계기는 로그를 표준 출력으로 내보내고 있었다. 그 출력은 집계기 파드와 운명을 같이한다.
파드를 지웠을 때 로그가 사라지던 ①번 문제가, 이번엔 집계기에서 똑같이 일어났다.
참고
한곳에 모으는 건 해결했다. 하지만 모은 것을 보관하는 곳이 없다. 표준 출력은 보관소가 아니다.
게다가 앞에서 본 것처럼 시간순 정렬도, "job_id 로 찾기" 같은 검색도 직접 스크립트를 짜야 했다.
뒤 편에서 집계기의 출력을 OpenSearch 로 바꾸는 이유다.
비용#
공짜는 아니다. 노드에서 컨테이너별 메모리를 쟀다.
| 컨테이너 | 메모리 |
|---|---|
| fluentd forwarder (lab-worker) | 129.6 MB |
| fluentd forwarder (lab-worker2) | 125 MB |
| fluentd aggregator | 75.03 MB |
| web (하나) | 79.13 MB |
| worker (하나) | 21.73 MB |
| rabbitmq | 156.5 MB |
로그 수집에만 약 330MB 를 쓴다. web 두 개와 worker 두 개를 합친 것(약 200MB)보다 크다.
CPU 는 조용할 때 0.5% 아래였다.
정리#
kubectl logs는 살아 있는 파드만 보여 준다. 파드를 지우면 NotFound 다. 장애 뒤에 가장 보고 싶은 로그를 볼 수 없다.- gunicorn 아래 Flask 는
app.logger.info가 안 찍힌다. gunicorn 로거에 붙여야 한다. 넣었는데 0줄이었다. - 컨테이너 로그는 노드의
/var/log/containers/에 CRI 형식으로 쌓인다. 이미지 기본 파서는json이라cri로 바꿔야 읽힌다. - 노드마다 forwarder(DaemonSet), 한곳에 aggregator. 소음(
/healthz56.9%)은 수집 단계에서 거른다. 작업 하나의 34줄이 파드 4개에 흩어져 있던 것을 한곳에서 찾았고, 지운 파드의 로그도 남았다. - 모은 로그는 도착 순서라 시간순이 아니다. 반드시 시간으로 다시 정렬해서 본다.
pos_file을 노드 디스크에 두면 재시작해도 중복이 없다.read_from_head true여도 옛 로그를 한 줄도 다시 보내지 않았다.- 표준 출력은 보관소가 아니다. 집계기가 바뀌자 581건이 사라졌다.
다음 편은 로그에 구조를 준다. 지금은 job=ebc49322e05a 같은 글자를 문자열로 뒤졌다. 폴링 소음과 진짜
사건을 가르고, 요청 하나를 들어온 순간부터 끝까지 한 번호로 따라가게 만든다.

댓글