앞 편에서 로그를 OpenSearch 에 쌓고 쿼리로 찾았다. 이번이 연재 마지막 편이다.
쌓은 로그를 화면으로 보고, 서비스가 느려진 이유를 찾는다.
"느리다" 는 말은 여러 가지를 뜻한다. 작업 자체가 느린가, 아니면 작업은 빠른데 차례를 기다리느라 늦는가.
둘은 대책이 정반대다. 전자는 코드를 고치고, 후자는 일손을 늘린다. 이번 편은 로그로 이 둘을 가른다.
무엇을 만드는가#
| 내용 | |
|---|---|
| 로그에 더할 것 | wait_ms — 작업이 큐에서 기다린 시간 |
| 실험 도구 | slowsite — 정확히 2초 걸리는 가짜 사이트 |
| 화면 | OpenSearch Dashboards 3.8.0 (Discover, 표, 막대그래프) |
| 결론 | 워커 2개 → 6개. 큐 대기 p50 10.0초 → 2.0초, 사용자 대기 최대 20.1초 → 8.0초 |
준비물#
- 지금까지 따라온 kind 클러스터, ArgoCD, gitops 저장소, Fluentd, OpenSearch
- Docker 메모리 여유 약 300MB (Dashboards)
- 걸리는 시간: 1시간 안팎
1. 느림을 둘로 나눌 칸을 만든다#
지금 로그로 알 수 있는 건 둘이다.
- worker 의
elapsed— 워커가 작업을 꺼낸 뒤 끝낼 때까지 - web 의
total_wait— 사용자가 접수한 뒤 결과가 나올 때까지
그 사이, 접수했는데 아직 아무 워커도 꺼내지 않은 시간이 비어 있다. 큐에서 줄 선 시간이다.
이걸 재려면 워커가 "이 작업이 언제 접수됐는지" 알아야 한다.
web 은 접수 시각을 메시지 본문에 함께 싣는다.
def _publish(job_id, url, request_id, queued_at):
    """큐에 작업을 넣는다. 넣기만 하고 결과는 기다리지 않는다.

    queued_at(접수 시각)을 함께 넣는다. 워커가 꺼낸 시각과 빼면 '큐에서 기다린 시간'이 된다.
    """
    ...
            body=_json.dumps({"job_id": job_id, "url": url, "queued_at": queued_at}),
worker 는 꺼낸 순간의 시각에서 빼서 job.start 와 job.done 에 남긴다.
    queued_at = job.get("queued_at")
    wait_ms = round((started - queued_at) * 1000, 1) if queued_at else None
    log("job.start", request_id=request_id, job_id=job_id, attempt=attempt,
max_attempts=MAX_ATTEMPTS, redelivered=method.redelivered, url=url, wait_ms=wait_ms)참고
web 과 worker 는 다른 파드지만 kind 노드는 모두 같은 맥 위의 컨테이너라 시계가 같다. 서버가 여러 대라면
시계가 조금씩 어긋날 수 있다. 그래서 운영에서는 NTP 로 시계를 맞춰 두고, 몇 밀리초 차이는 오차로 본다.
참고
재시도 메시지는 같은 본문을 다시 넣기 때문에
queued_at도 처음 접수 시각 그대로다. 그래서 재시도의
wait_ms에는 재시도 편의 대기(5초, 15초)까지 들어간다. 이번 실험은 모두 첫 시도에
성공하는 작업만 쓴다.
인덱스 템플릿에도 칸 타입을 한 줄 더한다. 안 넣으면 앞 편에서 본 것처럼
OpenSearch 가 짐작한다.
"wait_ms": { "type": "float" }2. 늘 2초 걸리는 가짜 사이트를 둔다#
병목을 재려면 처리 시간이 일정한 작업이 필요하다. 실제 사이트는 0.3초였다가 3초였다가 한다. 게다가 수십 건씩
두드리면 그 사이트에 폐다. 그래서 클러스터 안에 ?ms=2000 을 주면 정확히 2초 뒤에 답하는 사이트를 둔다.
이미지를 새로 만들 것 없이, 파이썬 표준 라이브러리만 쓴 스크립트를 ConfigMap 으로 넣는다.
apps/linkcard/k8s/40-slowsite.yaml 의 핵심만 보인다.
apiVersion: v1
kind: ConfigMap
metadata:
  name: slowsite
  namespace: linkcard
data:
  server.py: |
    import time, urllib.parse
    from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

    class Handler(BaseHTTPRequestHandler):
        def do_GET(self):
            u = urllib.parse.urlparse(self.path)
            if u.path == "/healthz":
                return self._send(b"ok", "text/plain")
            ms = int(urllib.parse.parse_qs(u.query).get("ms", ["0"])[0])
            time.sleep(min(ms, 20000) / 1000)
            html = (f'<html><head><title>slow {ms}ms</title>'
                    f'<meta property="og:title" content="느린 사이트 {ms}ms">'
                    f'<meta property="og:site_name" content="slowsite"></head>'
                    f'<body>ok</body></html>')
            self._send(html.encode(), "text/html; charset=utf-8")
        ...

    # 요청마다 스레드 하나. 느린 사이트 쪽이 병목이 되면 실험이 흐려진다.
    ThreadingHTTPServer(("0.0.0.0", 8080), Handler).serve_forever()
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: slowsite
  namespace: linkcard
spec:
  replicas: 1
  selector:
    matchLabels: { app: slowsite }
  template:
    metadata:
      labels: { app: slowsite }
    spec:
      containers:
        - name: slowsite
          image: python:3.12-slim
          command: ["python", "-u", "/app/server.py"]
          ports:
            - containerPort: 8080
          volumeMounts:
            - { name: script, mountPath: /app }
      volumes:
        - name: script
          configMap: { name: slowsite }
ThreadingHTTPServer 를 쓴 게 중요하다. 한 번에 한 요청만 받는 서버면 가짜 사이트가 병목이 되어,
워커를 늘려도 빨라지지 않는 엉뚱한 결과가 나온다.
워커 파드 안에서 불러 보면 2초가 걸린다.
kubectl exec -n linkcard deploy/linkcard-worker -- python -c
  "import time,urllib.request as u;t=time.time();b=u.urlopen('http://slowsite:8080/?ms=2000').read();print(round(time.time()-t,2),'s')"
2.01 s3. OpenSearch Dashboards 를 띄운다#
apps/logging/k8s/50-dashboards.yaml 을 만든다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: opensearch-dashboards
  namespace: logging
spec:
  replicas: 1
  selector:
    matchLabels: { app: opensearch-dashboards }
  template:
    metadata:
      labels: { app: opensearch-dashboards }
    spec:
      containers:
        - name: dashboards
          image: opensearchproject/opensearch-dashboards:3.8.0
          ports:
            - { name: http, containerPort: 5601 }
          env:
            - { name: OPENSEARCH_HOSTS, value: '["http://opensearch:9200"]' }
            - { name: DISABLE_SECURITY_DASHBOARDS_PLUGIN, value: "true" }
          readinessProbe:
            httpGet: { path: /api/status, port: 5601 }
            initialDelaySeconds: 30
            periodSeconds: 10
          resources:
            requests: { cpu: 100m, memory: 512Mi }
            limits:   { memory: 1Gi }
---
apiVersion: v1
kind: Service
metadata:
  name: opensearch-dashboards
  namespace: logging
spec:
  selector: { app: opensearch-dashboards }
  ports:
- { name: http, port: 5601, targetPort: 5601 }OPENSEARCH_HOSTS— 이미지의 시작 스크립트가 이 값을opensearch.hosts설정으로 바꿔 넣는다.DISABLE_SECURITY_DASHBOARDS_PLUGIN— 앞 편에서 OpenSearch 의 보안 플러그인을 껐으니 화면 쪽도 뺀다. 이미지 기본 설정은kibanaserver계정으로https://에 붙으려 한다.
주의
Ingress 를 만들지 않았다. 보안을 끈 Dashboards 는 들어오기만 하면 인덱스를 지우는 것까지 된다.
그리고 kind 의 80 포트가 어디에 열려 있는지 보면 이렇다.
bash

docker port lab-control-plane
80/tcp -> 0.0.0.0:80

443/tcp -> 0.0.0.0:443
0.0.0.0은 "이 맥의 모든 네트워크" 라는 뜻이다. Ingress 에 걸면 같은 공유기의 다른 기기에서도 들어온다.
그래서 볼 때만port-forward로 내 맥(127.0.0.1)에만 연다.
이미지(약 510MB)는 앞 편처럼 노드에 미리 받아 둔다. 그리고 앞의 코드 변경, slowsite, Dashboards 를 한꺼번에 커밋·푸시한다.
for n in lab-worker lab-worker2; do
  docker exec $n crictl pull docker.io/opensearchproject/opensearch-dashboards:3.8.0 &
done; wait

docker build -t linkcard-web:v10 apps/linkcard/web
docker build -t linkcard-worker:v4 apps/linkcard/worker
kind load docker-image linkcard-web:v10 linkcard-worker:v4 --name lab
# 20-web.yaml → v10, 30-worker.yaml → v4 로 바꾼 뒤
git add -A && git commit -m "병목을 재기 위한 준비 — 큐 대기 시간, 느린 사이트, OpenSearch Dashboards"
git push origin main
+0초 linkcard=18d2793/Healthy logging=18d2793/Healthy
+5초 linkcard=1b072d6/Progressing logging=1b072d6/Progressing
+21초 linkcard=1b072d6/Healthy logging=1b072d6/Progressing
+36초 linkcard=1b072d6/Healthy logging=1b072d6/Healthy열어 본다.
kubectl port-forward -n logging svc/opensearch-dashboards 5601:5601브라우저에서 http://localhost:5601 로 들어간다.
인덱스 패턴을 만든다#
Dashboards 는 먼저 "어느 인덱스를 볼지" 정해야 한다. Dashboards Management → Index patterns → Create 에서
linkcard-* 를 넣고, 시간 칸으로 @timestamp 를 고른다.
주의
나는 이걸 화면 대신 API 로 만들었다가, 시각화를 열자 이런 오류를 만났다.
Saved object is missing

Could not locate that index-pattern-field (id: wait_ms)
인덱스 패턴은 만들 때 칸 목록을 복사해 둔다. API 로 제목만 넣어 만들면 칸 목록이 비어 있고, 나중에 생긴
wait_ms같은 칸도 모른다. 화면에서 만들면 칸 목록을 알아서 채운다. 이미 만든 패턴은 Index patterns →
linkcard-* → 새로고침 버튼으로 칸 목록을 다시 읽힌다. 새 칸을 로그에 더했을 때도 이렇게 한다.
참고
인덱스 패턴과 시각화는 OpenSearch 안의
.kibana인덱스에 저장된다. gitops 저장소에는 남지 않는다.
저장소에 두고 싶으면 Saved objects → Export 로 받은.ndjson을 커밋해 두고, 새 클러스터에서 Import 한다.
4. 실험 — 2초짜리 작업 20건을 한꺼번에#
워커 2개인 지금 상태에서, 2초짜리 작업 20건을 한꺼번에 넣는다. 요청 번호는 w2-000 ~ w2-019 로 붙인다.
for i in range(20):
    rid = f"w2-{i:03d}"
    req = urllib.request.Request(
        "http://localhost/linkcard/api/cards",
        data=json.dumps({"url": "http://slowsite:8080/?ms=2000"}).encode(),
        headers={"Content-Type": "application/json", "X-Request-ID": rid})
    urllib.request.urlopen(req)
넣는 동안 2초마다 RabbitMQ 큐에 꺼내 가지 않은 메시지 수를 적었다.
kubectl exec -n linkcard rabbitmq-0 -- rabbitmqctl -q list_queues name messages_ready messages_unacknowledged결과다.
접수 20건: 0.28초
모두 끝: 22.2초  상태 {'done': 20}  미완 0
큐 깊이 샘플 9개, 최대 대기 18건 (+0.6초)
  + 0.6s:18  + 3.1s:16  + 5.7s:14  + 8.2s:12  +10.8s:8  +13.3s:6  +15.8s:4  +18.4s:0  +21.0s:0
사용자가 기다린 시간(total_wait) p50=12.1s max=20.1s
접수는 20건에 0.28초로 바로 끝났다. 그런데 마지막 사용자는 결과를 20.1초 기다렸다. 큐에 쌓인 18건이
2초마다 2건씩 줄어든다.
Discover — 한 건씩 본다#
Discover 에서 시간 범위를 실험 시각으로 맞추고 이렇게 검색한다.
request_id:w2-* and event:job.done왼쪽 칸 목록에서 event, request_id, pod, wait_ms, elapsed 를 골라 표에 띄운다.
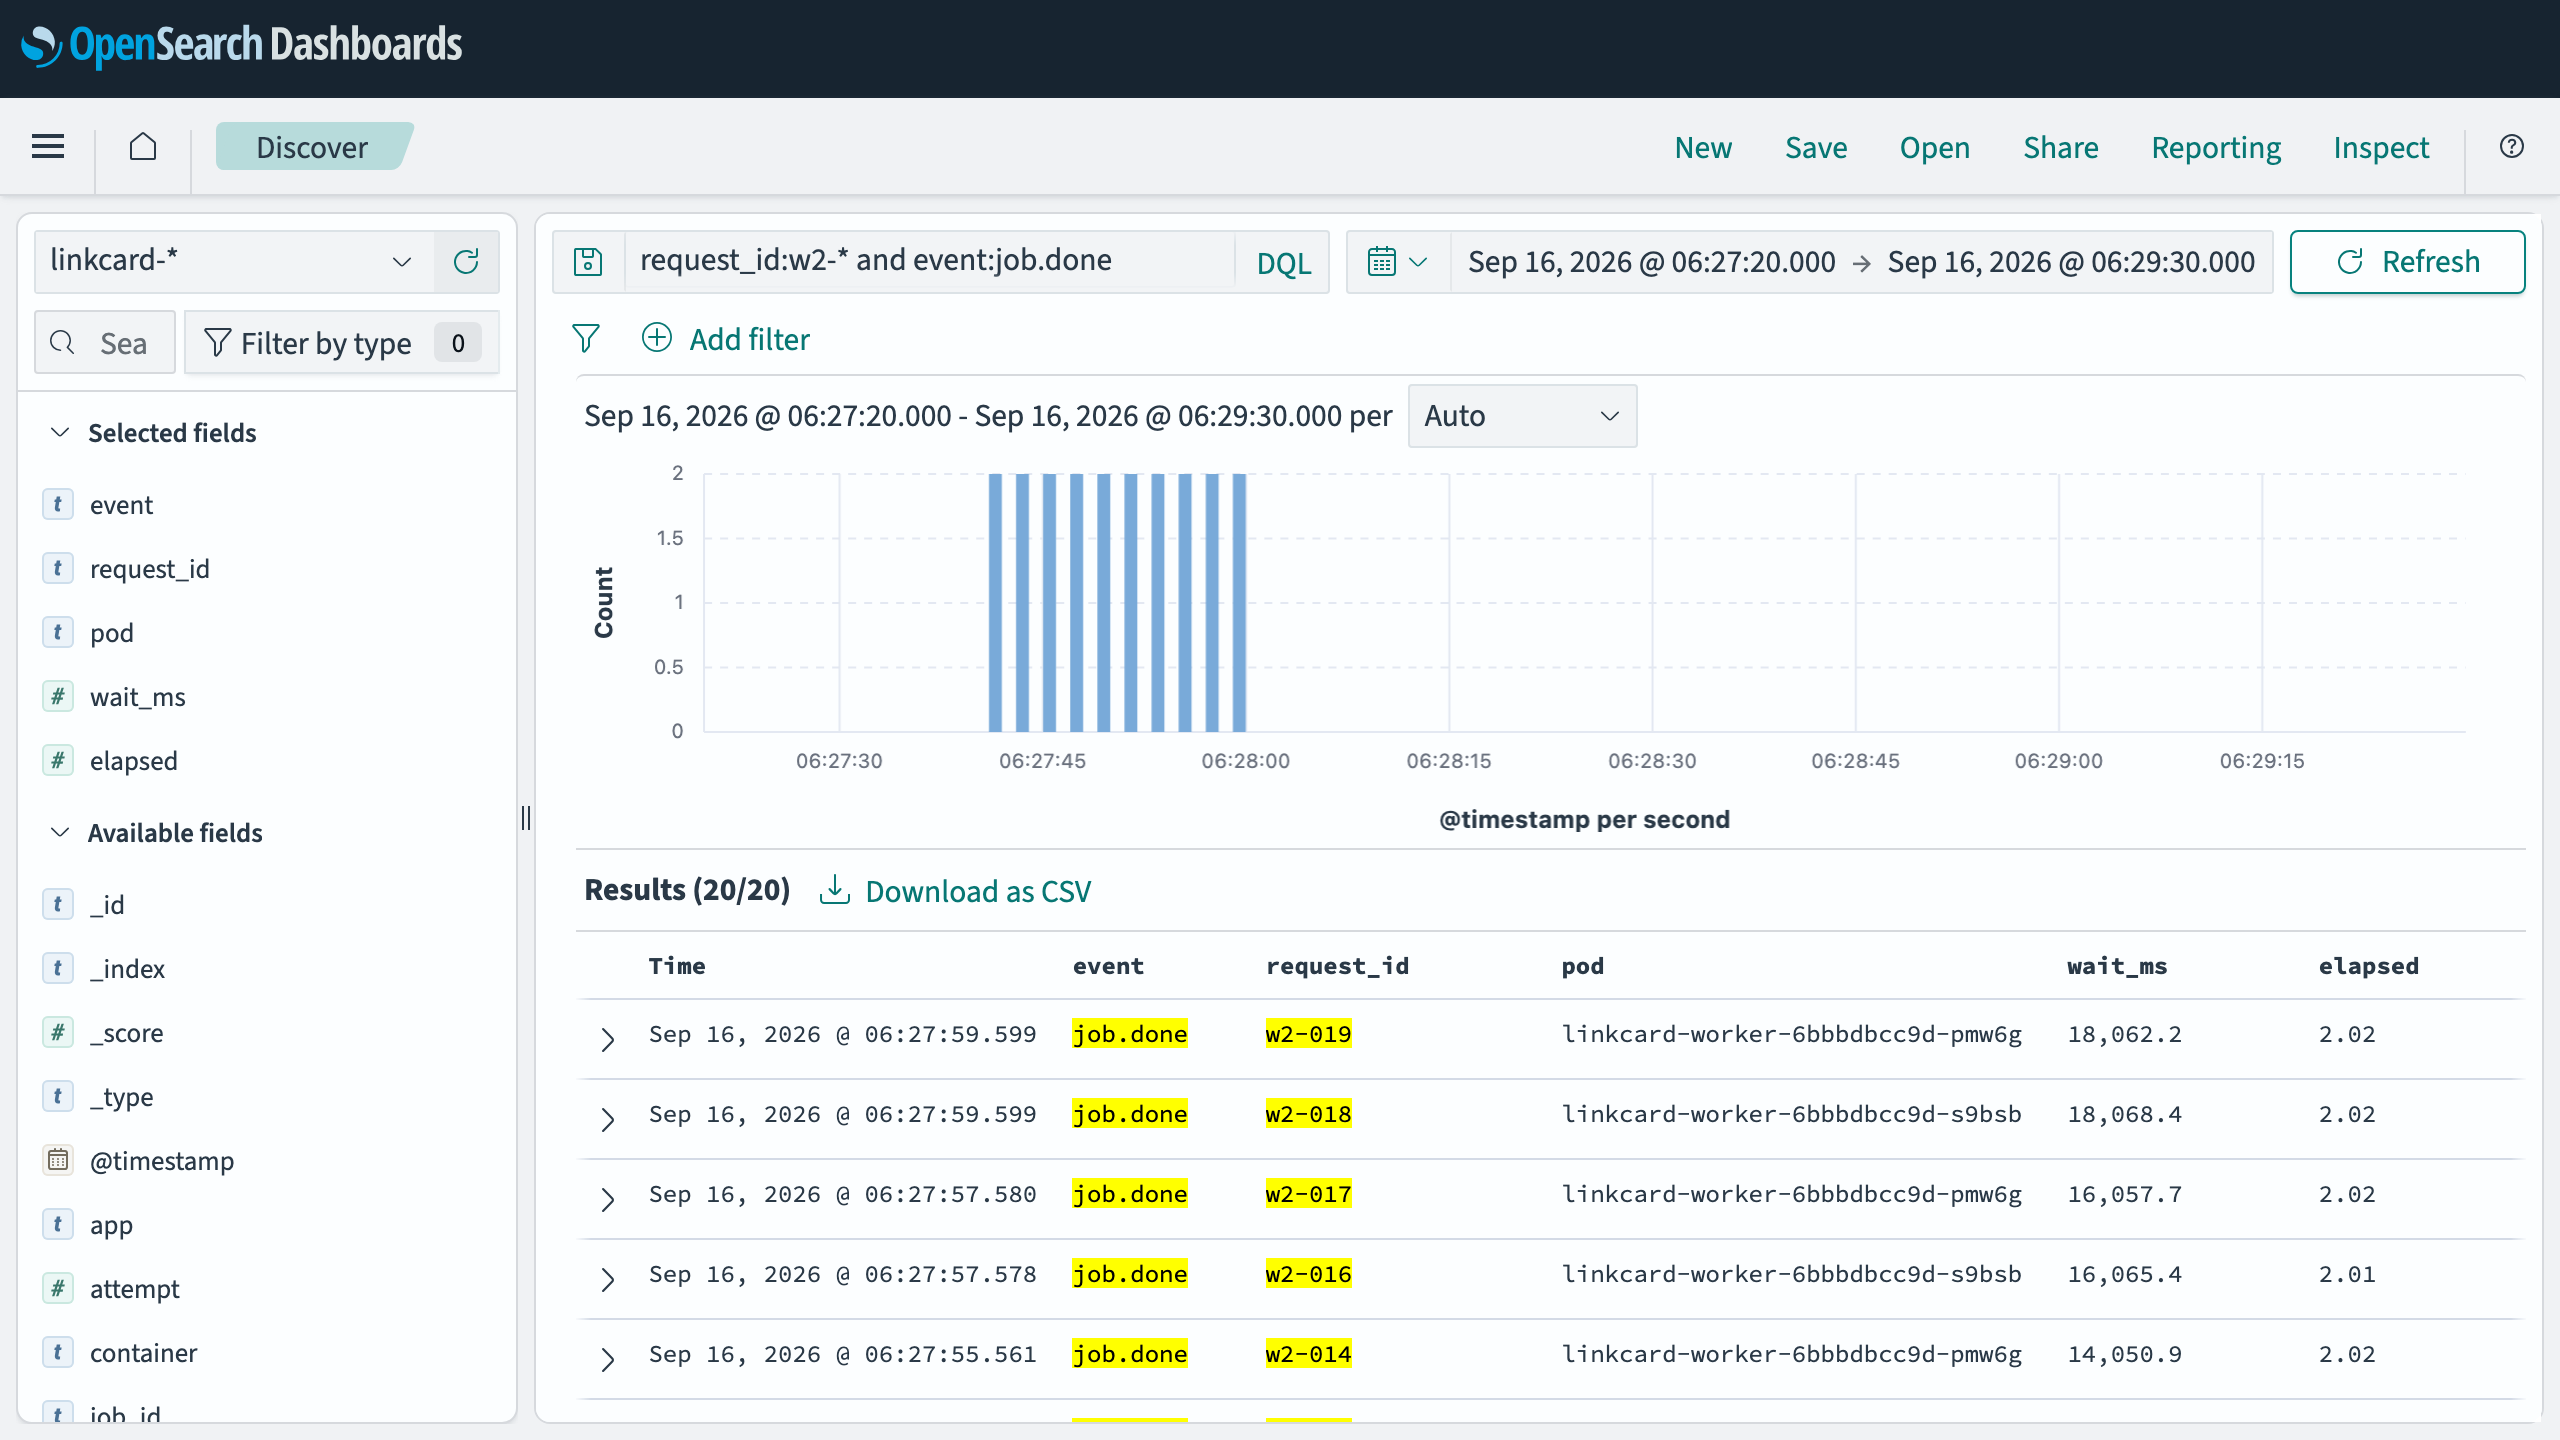
화면 하나에 답이 다 있다.
elapsed(처리 시간)는 모두 2.02초 안팎이다. 작업은 느려지지 않았다.wait_ms(큐 대기)는 18초, 16초, 14초… 2초씩 계단이다. 늦게 들어온 작업일수록 더 오래 기다렸다.pod칸에는 워커 두 개(pmw6g,s9bsb)가 번갈아 나온다. 막대그래프도 2초마다 두 건씩이다.
참고
화면의 시각은 브라우저 시간대(여기서는 한국 시각)로 보인다. 저장된
@timestamp는 UTC 다.
막대그래프 — 계단을 한눈에#
Visualize → Create → Vertical bar 로 만든다.
| 설정 | 값 |
|---|---|
| 검색 | event:"job.start" and request_id:w* |
| Y축 | Max of wait_ms |
| X축 | Date histogram, @timestamp, 1초 간격 |
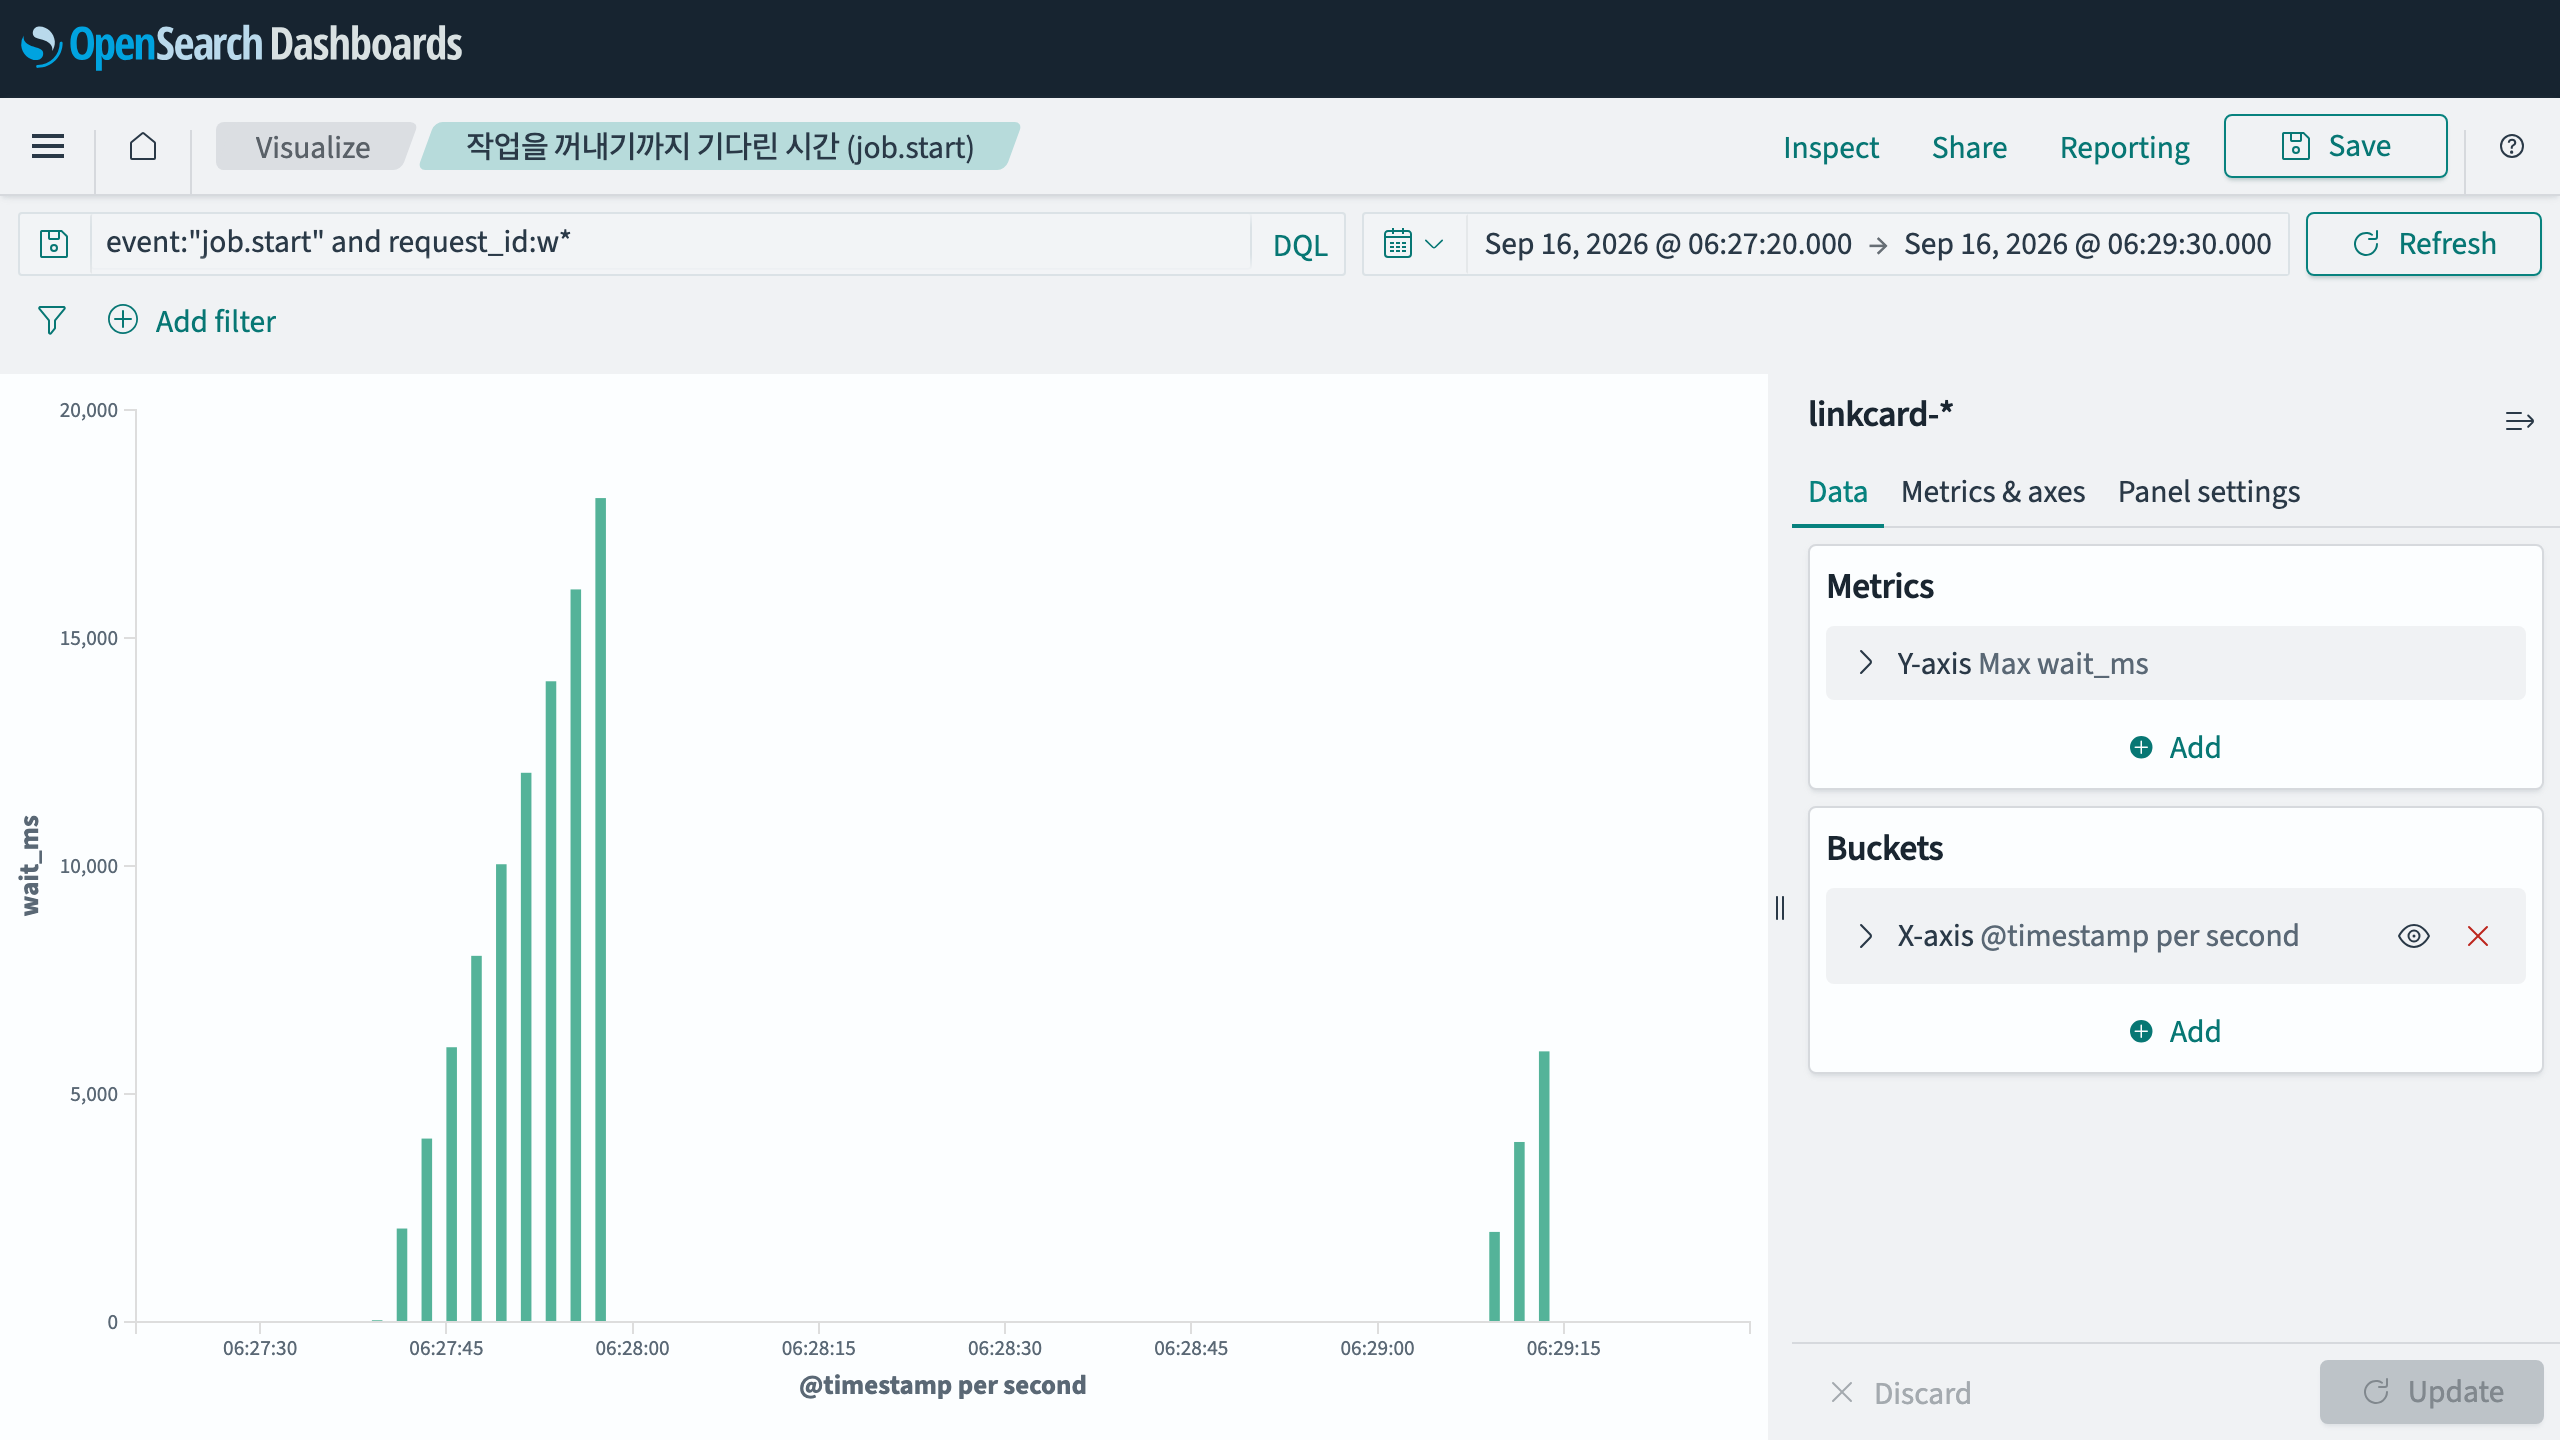
왼쪽 무리가 워커 2개일 때다. 막대가 오른쪽으로 갈수록 높아진다 — 워커가 꺼낼 때마다 기다린 시간이 2초씩 늘었다.
오른쪽 무리는 뒤에서 워커를 늘린 뒤의 같은 실험이다.
표 — 숫자로 확정#
job.done 한 줄에는 wait_ms 와 elapsed 가 둘 다 있다. Data table 을 만들어 백분위를 나란히 둔다.
| 설정 | 값 |
|---|---|
| 검색 | event:"job.done" |
| Metric | Count / Percentiles of wait_ms (50, 95) / Percentiles of elapsed (50, 95) |
| Split rows | Filters — request_id:w2-* (워커 2개), request_id:w6-* (워커 6개) |
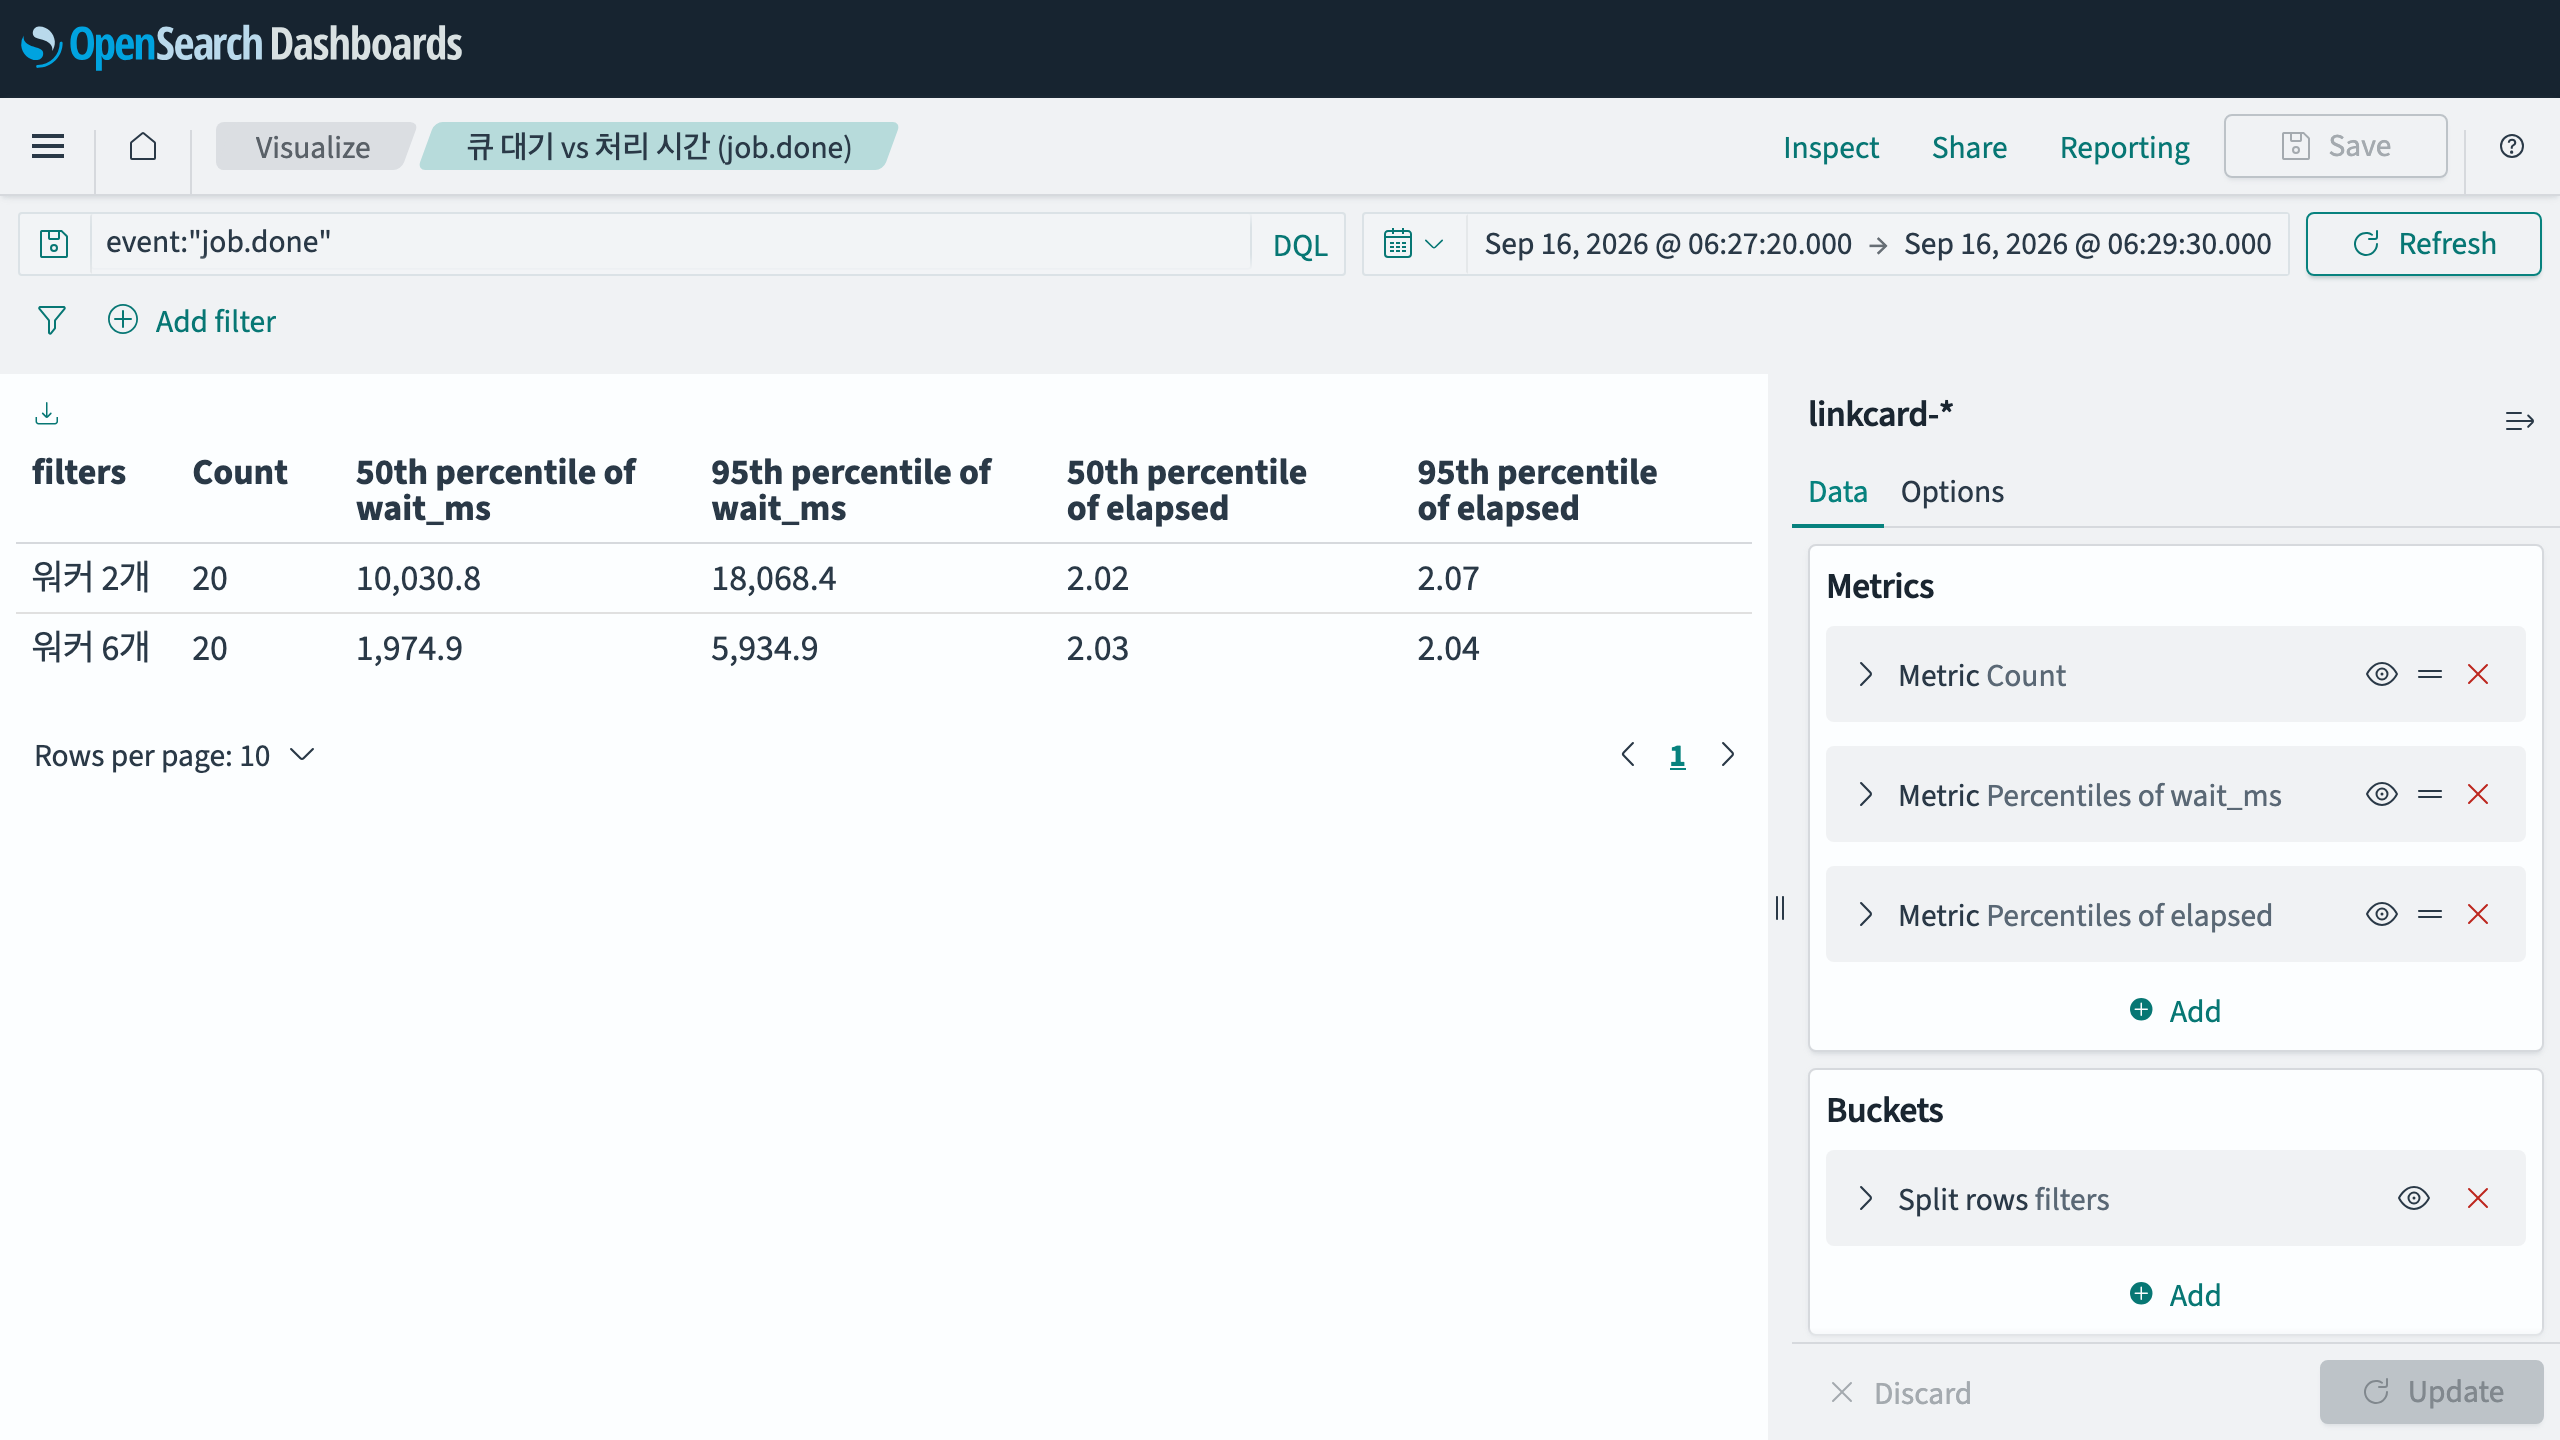
첫 줄(워커 2개)만 보자.
| p50 | p95 | |
|---|---|---|
큐 대기 wait_ms |
10,030.8 ms | 18,068.4 ms |
처리 elapsed |
2.02 s | 2.07 s |
사용자가 기다린 시간의 대부분이 큐 대기다. 처리 시간은 건당 2초로 일정하다. 병목은 코드가 아니라
동시에 일하는 워커 수다.
팁
숫자가 계산과도 맞는다. 워커 2개가 2초에 2건씩 처리하면, 20건 중 마지막 두 건은 앞의 18건이 끝나기를
9번(18초) 기다린다. 측정한 최대 대기는 18.07초였다. 계산으로 맞는 숫자가 나오면 원인을 제대로 짚은 것이다.
5. 워커를 늘린다 — 역시 gitops 로#
30-worker.yaml 의 replicas 를 2에서 6으로 바꾼다.
spec:
  # 9편에서 2 → 6. 느린 작업 20건을 넣자 처리는 건당 2초인데 큐 대기가 p50 10초였다.
  # 병목은 워커 수였다. 늘리면 처리량이 그대로 늘어난다.
  replicas: 6
git add apps/linkcard/k8s/30-worker.yaml
git commit -m "worker 2 → 6 — 병목은 워커 수였다"
git push origin main동기화가 끝나자 워커 6개가 두 노드에 나뉘어 떴고, RabbitMQ 의 card.jobs 큐에 붙은 소비자도 6이 됐다.
kubectl exec -n linkcard rabbitmq-0 -- rabbitmqctl -q list_queues name consumerscard.jobs 6같은 실험을 요청 번호 w6-000 ~ w6-019 로 다시 한다.
접수 20건: 0.23초
모두 끝: 9.7초  상태 {'done': 20}  미완 0
큐 깊이 샘플 4개, 최대 대기 14건 (+0.5초)
  + 0.5s:14  + 3.1s:8  + 5.6s:2  + 8.2s:0
  워커별 처리: {'pmw6g': 4, 's9bsb': 4, 'd5w4f': 3, 'gc7sc': 3, 'tq8bk': 3, 'xjx5r': 3}
사용자가 기다린 시간(total_wait) p50=4.0s max=8.0s
큐가 2초마다 6건씩 준다. 위의 표와 막대그래프 오른쪽 무리가 이 실험이다.
| 워커 2개 | 워커 6개 | |
|---|---|---|
| 큐 대기 p50 | 10,030.8 ms | 1,974.9 ms |
| 큐 대기 p95 | 18,068.4 ms | 5,934.9 ms |
| 처리 elapsed p50 | 2.02 s | 2.03 s |
| 사용자 대기 p50 | 12.1 s | 4.0 s |
| 사용자 대기 최대 | 20.1 s | 8.0 s |
| 20건이 모두 끝나기까지 | 22.2 s | 9.7 s |
처리 시간은 그대로(2.02 → 2.03초)고 기다리는 시간만 줄었다. 병목을 제대로 짚었다는 뜻이다. 최대 대기도
계산(20건 ÷ 6개 = 네 번째 묶음이 앞의 세 묶음 × 2초를 기다림 = 6초)과 맞는다(5.93초).
참고
워커를 3배로 늘렸는데 "모두 끝나기까지" 는 3배가 아니라 2.3배 빨라졌다. 20건이 적어서 6개 워커가 네 번(8초)에
끝내고, 결과를 확인하는 스크립트가 1초마다 물어보는 간격이 더해졌다. 짧은 실험에서는 전체 소요 시간보다
건마다의 대기 시간을 보는 편이 정확하다.
6. 늘리면 끝인가#
아니다. 이번엔 워커가 병목이었지만, 워커를 계속 늘리면 다른 곳이 병목이 된다.
- 처리 시간
elapsed가 늘기 시작하면 → 워커 뒤쪽(여기선 가짜 사이트, 실제로는 바깥 사이트나 DB)이 버거운 것이다. - web 의
http.accessms가 늘면 → 접수하는 쪽(gunicorn 워커 2개)이 버거운 것이다. 꼬리 지연 편에서 본 문제다. - 큐 대기는 줄었는데 노드 메모리가 모자라면 → 파드를 늘릴 자리가 없는 것이다.
어느 쪽이든 대기와 처리를 나눠서 남겨 둔 로그가 있으면 같은 방법으로 찾는다. 이번 편의 요점은 워커 6이라는
숫자가 아니라 이 나눔이다.
팁
큐에 쌓인 메시지 수를 보고 워커 수를 자동으로 늘렸다 줄이는 방법도 있다(KEDA 의 RabbitMQ 스케일러 등).
다만 자동으로 늘리기 전에, 늘려서 정말 빨라지는 병목인지 이번처럼 먼저 확인해 둔다.
비용#
| 컨테이너 | 메모리 |
|---|---|
| OpenSearch Dashboards | 299.7 MB |
| OpenSearch | 1.02 GB (한도 1GB) |
| worker (하나) | 약 22 MB × 6 |
연재를 마치며#
아홉 편 동안 만든 것을 한 줄씩 적는다.
| 편 | 만든 것 | 알게 된 것 |
|---|---|---|
| 1 | 연재 계획, 링크 카드 앱 | 무엇을 왜 쪼개는가 |
| 2 | web · fetcher 첫 배포 | gitops 로만 배포한다 |
| 3 | 부하 실험 | 평균이 아니라 꼬리 지연을 본다 |
| 4 | RabbitMQ 큐, Redis | 접수와 처리를 떼어 놓는다 |
| 5 | 재시도 · DLQ | 다시 할 실패와 끝낼 실패를 가른다 |
| 6 | Fluentd forwarder · aggregator | 흩어진 로그를 모은다 |
| 7 | X-Request-ID · correlation_id | 요청 하나를 번호 하나로 따라간다 |
| 8 | OpenSearch · 인덱스 템플릿 | 로그를 보관하고 칸으로 찾는다 |
| 9 | Dashboards · wait_ms | 느림을 대기와 처리로 나눈다 |
정리#
- "느리다" 는 대기와 처리 두 가지다. 대책이 반대라 먼저 가른다. 로그에
wait_ms(큐 대기)와elapsed(처리)를 따로 남긴다. - 큐 대기를 재려면 접수 시각을 메시지에 싣는다. 워커가 꺼낸 순간의 시각에서 뺀다.
- 실험은 처리 시간이 일정한 작업으로 한다. 가짜 사이트 자체가 병목이 되지 않게 요청마다 스레드를 준다.
- Dashboards 인덱스 패턴은 칸 목록을 복사해 둔다. 새 칸이 생기면 새로고침한다. 안 하면
Could not locate that index-pattern-field가 난다. - 보안을 끈 Dashboards 는 Ingress 로 열지 않는다. kind 의 80 포트는
0.0.0.0에 열려 있다.port-forward로 본다. - 계산이 맞으면 원인이 맞다. 워커 2개일 때 최대 대기 18.07초(계산 18초), 6개일 때 5.93초(계산 6초). 처리 시간은 그대로고 대기만 줄었다.

댓글