애플리케이션이 갑자기 멈춘다. 예외도 안 나고, 그냥 발행에서 멈춰 있다.
그러다 이런 게 뜬다.
pika.exceptions.ConnectionBlockedTimeout: Blocked connection timeout expired.RabbitMQ 가 죽은 게 아니다. 일부러 막은 것이다. 소비보다 발행이 빨라 큐가
쌓이고, 그 데이터가 디스크를 갉아먹다가 한계선을 넘으면 브로커가 발행하는
연결만 골라 읽기를 멈춘다. 이게 백프레셔다.
이 글은 그 과정을 실제로 알람을 띄워 재현하고, rabbitmqctl 로 원인을 찾아
푸는 순서를 정리한다.
참고
붙여 넣은 출력은 전부 RabbitMQ 3.12.1 (Erlang 25) 을 띄우고 실제로 알람을
발생시켜 얻은 것이다. 큐 이름과 건수는 재현용이다.
무슨 일이 벌어지나#
| 단계 | 상태 |
|---|---|
| 1 | 소비보다 발행이 빠르다 → messages_ready 가 계속 는다 |
| 2 | 쌓인 메시지가 디스크를 먹는다 (delivery_mode=2 면 특히) |
| 3 | 남은 디스크가 disk_free_limit 아래로 내려간다 |
| 4 | 디스크 알람 발생 |
| 5 | 브로커가 발행하는 연결의 소켓 읽기를 멈춘다 |
| 6 | 클라이언트는 connection.blocked 를 받고 발행이 멈춘다 |
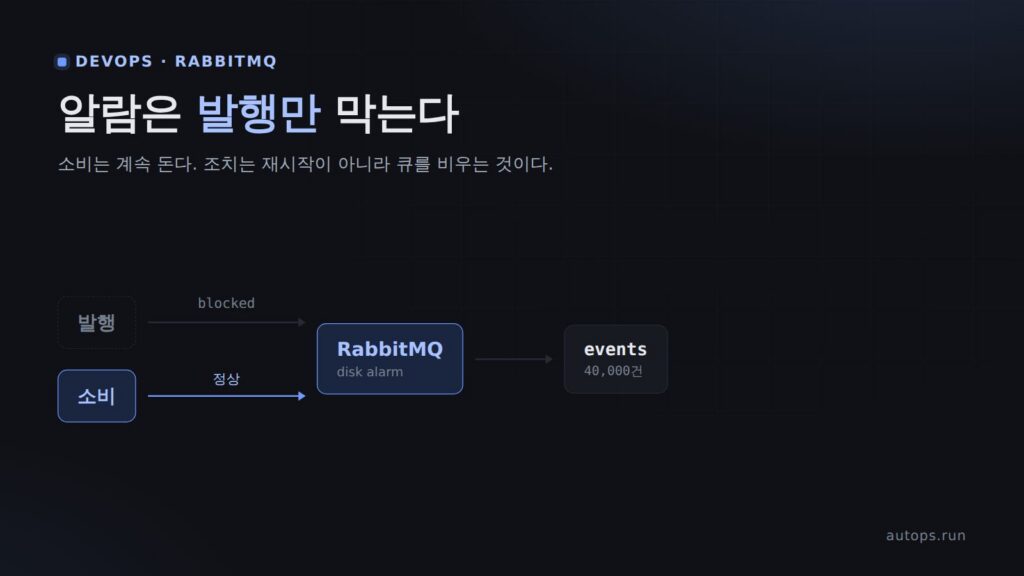
핵심은 5번이 발행에만 걸린다는 것이다. 소비는 계속 돌아간다. 이 사실이
뒤에서 나올 조치의 근거가 된다.
참고
알람 계기는 둘이다 — 디스크(
disk_free_limit)와 메모리
(vm_memory_high_watermark). 어느 쪽이 켜져도 발행이 막히는 결과는 같다.
이 글은 디스크 쪽을 다루지만 진단·해제 순서는 거의 같다.
1. 지금 알람이 켜져 있나#
가장 먼저 볼 것. 애플리케이션 로그를 뒤지기 전에 여기부터다.
팁
서버가 여러 대라 로그를 일일이
ssh로 열어 보고 있다면, 그걸 한곳으로 모으는
이야기는 Fluentd 처음 배우기에 따로 있다.
rabbitmq-diagnostics alarms알람이 없으면 이렇게 나온다.
Asking node rabbit@... to report any known resource alarms ...
Node rabbit@... reported no alarms, local or clusterwide
켜져 있으면 어느 자원인지 한 줄로 알려 준다.
Asking node rabbit@... to report any known resource alarms ...
Free disk space alarm on node rabbit@...
이 한 줄이 나오면 원인 규명은 사실상 끝났다. 애플리케이션이 느린 게 아니라
브로커가 막고 있는 것이다.
2. 한계선과 현재 여유를 본다#
rabbitmqctl status디스크와 메모리 부분만 보면 된다.
Free Disk Space
Low free disk space watermark: 40.0 gb
Free disk space: 31.9704 gb

Memory high watermark setting: 0.4 of available memory, computed to: 6.7424 gb
여유(31.97)가 한계선(40.0) 아래라서 알람이 켜진 상태다. 지금 설정값만
따로 보려면 이렇게 한다.
rabbitmqctl environment | grep -E "disk_free_limit|vm_memory_high_watermark" {disk_free_limit,50000000},
{vm_memory_high_watermark,0.4},기본값은 디스크 50MB, 메모리는 전체의 40% 다. 디스크 기본값 50MB 는 대단히
빡빡하다 — 알람이 뜬 시점에 이미 손쓸 여유가 거의 없다는 뜻이다. 운영에서는
올려 잡는다.
3. 어느 큐가 범인인가#
알람은 노드 단위라 "무엇 때문에"를 말해 주지 않는다. 큐를 늘어놓고 찾는다.
rabbitmqctl list_queues name messages messages_ready messages_unacknowledged consumersname messages messages_ready messages_unacknowledged consumers
orders 200 200 0 0
emails 120 120 0 0
events 40000 40000 0 0events 가 4만 건인데 consumers 가 0 이다. 소비자가 아예 안 붙어 있다.
읽는 법은 이렇다.
| 보이는 모양 | 뜻 | 볼 곳 |
|---|---|---|
consumers 가 0 |
소비자가 죽었거나 못 붙었다 | 소비 애플리케이션·네트워크 |
messages_ready 만 큼 |
소비 속도가 못 따라간다 | 소비자 수·처리 시간 |
messages_unacknowledged 가 큼 |
받아는 갔는데 ack 를 못 한다 | 소비자 안의 느린 처리·예외 |
세 번째가 가장 헷갈린다. 소비자를 붙였는데도 큐가 안 줄면 이걸 본다.
name    messages  messages_ready  messages_unacknowledged  consumers
orders  5000      4800            200                      1
200건이 소비자 손에 들려 있는데 ack 가 안 돌아온다. 이 값은 대개
prefetch_count 에서 멈춘다 — 위 200 도 basic_qos(prefetch_count=200) 이다.
소비자가 살아는 있으나 한 건 처리가 너무 오래 걸리거나, 예외로 ack 를 못 하고
있다는 신호다.
디스크를 실제로 얼마나 먹고 있나#
rabbitmqctl list_queues name messages memory message_bytes_ram message_bytes_persistentname messages memory message_bytes_ram message_bytes_persistent
orders 200 164008 799 1690
emails 120 176800 7 970
events 40000 12118136 7 428890message_bytes_persistent 가 디스크에 적힌 양이다. 어느 큐가 디스크를
밀어내고 있는지 여기서 갈린다.
주의
quorum 큐에서는 이 칼럼이 비어 있다.
message_bytes계열이 채워지지
않아서 이 진단이 통하지 않는다. quorum 을 쓴다면 8장으로 간다.
4. 어느 연결이 막혔나#
rabbitmqctl list_connections name statename state
127.0.0.1:40856 -> 127.0.0.1:5672 blocking
127.0.0.1:35316 -> 127.0.0.1:5672 blocked두 상태는 다르다.
| 상태 | 뜻 |
|---|---|
blocking |
알람은 켜졌지만 이 연결은 아직 발행을 시도하지 않았다 |
blocked |
발행을 시도했고 지금 막혀 있다 |
blocked 로 뜬 연결의 주소가 곧 멈춰 있는 애플리케이션이다. 어느 서비스가
멈췄는지 모를 때 여기서 IP 로 찾는다.
팁
클라이언트에서
connection.blocked알림을 받도록 해 두면 애플리케이션이
"막혔다"를 스스로 알 수 있다. 위 pika 예외(ConnectionBlockedTimeout)도
blocked_connection_timeout을 준 덕에 무한정 매달리지 않고 떨어진 것이다.
이 값을 안 주면 발행이 조용히 영원히 멈춘다.
5. 소비는 계속된다 — 이걸 이용한다#
여기가 조치의 핵심이다. 알람이 켜진 상태에서도 소비자는 정상 동작한다.
실제로 확인했다. 알람을 켜 둔 채 5000건짜리 큐에 소비자를 붙였다.
$ rabbitmq-diagnostics alarms
Free disk space alarm on node rabbit@...

$ rabbitmqctl list_queues name messages
orders   5000

# 소비자를 붙이고
소비하고 ack 한 건수: 5000

$ rabbitmqctl list_queues name messages
orders   0

$ rabbitmq-diagnostics alarms
Free disk space alarm on node rabbit@...      ← 알람은 여전히 켜져 있다
알람 중에도 5000건을 전부 빼냈다. 그러니 순서는 이렇다.
- 발행 쪽은 브로커가 이미 막아 두었다 — 더 밀어 넣을 걱정은 없다
- 소비자를 늘리거나 되살려 큐를 비운다
- 디스크가 회복되면 알람이 저절로 풀린다
브로커를 재시작하지 않는다. 재시작하면 알람은 사라지지만 쌓인 메시지는 그대로라
디스크가 그대로고, 발행이 재개되면서 곧바로 다시 찬다.
6. 급할 때 — 한계선을 임시로 내린다#
소비자를 못 붙이는 상황이라면 한계선을 조정해 숨통을 틔울 수 있다.
rabbitmqctl set_disk_free_limit 2GBSetting disk free limit on rabbit@... to 2GB bytes ...몇 초 뒤 알람이 풀린다.
$ rabbitmq-diagnostics alarms
Node rabbit@... reported no alarms, local or clusterwide

$ # 발행이 다시 된다
200건 발행 완료 (0.0s)주의
이건 해결이 아니라 유예다. 한계선을 내리는 건 화재경보기 소리를 줄이는
것에 가깝다. 진짜 디스크가 차면 그때는 알람이 아니라 노드가 죽고, 그 상태에서
복구는 훨씬 어렵다. 반드시 소비를 회복시키거나 디스크를 늘리는 조치를 같이
한다.
이 명령은 재시작하면 사라진다. 영구 설정은 /etc/rabbitmq/rabbitmq.conf
에 둔다.
disk_free_limit.absolute = 5GB
# 또는 램 크기에 비례해서
# disk_free_limit.relative = 1.5
7. 다시 안 겪으려면#
한계선을 현실적으로 잡는다. 기본 50MB 는 알람이 떴을 때 이미 늦다. 디스크가
한 시간 치 유입을 더 받을 수 있을 만큼 여유를 두고 잡는다.
큐 깊이에 상한을 건다. 쌓이는 것을 무한정 허용하지 않는다.
rabbitmqctl set_policy cap "^events$"
  '{"max-length":100000,"overflow":"reject-publish"}' --apply-to queues
reject-publish 면 상한을 넘는 발행이 거절된다. 브로커 전체가 막히는 것보다
그 큐의 발행자만 실패를 받는 편이 훨씬 낫다 — 장애가 한 큐 안에 갇힌다.
소비자에 예외 처리를 둔다. messages_unacknowledged 가 쌓이는 사고의
대부분은 소비자가 예외를 삼키고 ack 도 nack 도 안 하는 코드다.
알람을 감시한다. 디스크 사용률보다 알람 자체가 정확한 신호다. 감시에는
alarms 가 아니라 check_alarms 를 쓴다.
rabbitmq-diagnostics -q check_alarms && echo "정상" || echo "알람 있음"주의
rabbitmq-diagnostics alarms는 알람이 있어도 종료 코드가 0 이다. 사람이
눈으로 보라고 만든 명령이라 그렇다. 이걸로 감시를 걸면 알람을 영영 못 잡는다.
확인해 보면 이렇게 갈린다.
`
$ rabbitmq-diagnostics -q alarms # 알람 있는 상태
Free disk space alarm on node rabbit@…
exit=0 ← 실패로 안 잡힌다$ rabbitmq-diagnostics -q check_alarms # 같은 상태
Free disk space alarm on node rabbit@…
exit=69 ← 이걸 써야 한다
`
8. quorum 큐를 쓴다면#
quorum 큐는 Raft 로 복제되는 큐라 디스크 이야기가 달라진다. 위 순서는 대체로
그대로지만 네 가지가 바뀐다.
진단 칼럼이 비어 있다#
3장에서 쓴 명령을 quorum 큐에 돌리면 이렇게 나온다.
name             type     messages  message_bytes  message_bytes_ram  message_bytes_persistent
orders_qq        quorum   20000                    0
events           classic  40000     428890         19370              428890
quorum 쪽은 빈칸이다. 대신 Raft 상태를 본다.
rabbitmq-queues quorum_status orders_qqNode Name Raft State Log Index Commit Index Snapshot Index Term Machine Version
rabbit@vm leader 20004 20004 undefined 1 3Snapshot Index 가 undefined — 스냅샷이 아직 없다는 뜻이고, 그러면 로그
20004개가 통째로 디스크에 남는다. 소비되지 않은 백로그가 디스크를 잡고 있는
실체가 이것이다. 이 값이 Log Index 에서 한참 뒤처져 있으면 그 큐가 범인이다.
디스크가 복제 수만큼 곱해진다#
quorum 큐는 모든 replica 에 같은 Raft 로그를 쓴다. replica 3벌이면 클러스터
전체 디스크 소모는 대략 3배다. classic 큐 감각으로 한계선을 잡아 두면 예상보다
훨씬 빨리 알람이 뜬다.
비워도 디스크가 곧바로 줄지 않는다#
여기가 5장과 어긋나는 지점이다. 2만 건짜리 quorum 큐를 전부 소비하고 ack 한
전후를 재 봤다.
소비 전:  디렉터리 5.8M   Log 20004   Snapshot undefined
          ↓  20000건 전부 ack
소비 후:  디렉터리 9.3M   Log 39150   Snapshot 39149
줄기는커녕 늘었다. ack 하나하나가 다시 Raft 로그 항목이라 로그가 더 길어진다.
다만 안을 열어 보면 갈린다.
00000002.wal            9.2M    ← 노드 공용 WAL
2F_ORDIF4DGPP77036       20K    ← 이 큐의 세그먼트
큐별 데이터는 5.8M 에서 20K 로 제대로 줄었다. 남은 덩치는 노드가 공용으로
쓰는 WAL 이고, 이건 일정 크기에서 롤오버될 때 정리된다.
참고
그러니 "소비하면 회복된다"는 quorum 에서도 맞지만 즉시는 아니다. 큐를 다
비웠는데df가 그대로라고 당황하지 않는다. 80초를 더 지켜봐도 9.3M 그대로인
것까지 확인했다 — WAL 이 롤오버될 때까지 기다리거나, 정말 급하면 그때
한계선을 조정한다(6장).
overflow 정책이 조용히 무시된다#
7장의 reject-publish 는 quorum 에서도 동작한다. 그런데 reject-publish-dlx
는 quorum 이 지원하지 않는다. 문제는 그걸 걸어도 아무도 말려 주지 않는다는
것이다.
rabbitmqctl set_policy qq_dlx "^orders_qq$"
  '{"max-length":10000,"overflow":"reject-publish-dlx"}' --apply-to queues
Setting policy "qq_dlx" for pattern "^orders_qq$" ... ← 성공했다고 한다조회해도 멀쩡히 걸려 있는 것처럼 보인다.
name       type    policy  effective_policy_definition
orders_qq quorum qq_dlx [{<<"max-length">>, 10000}, {<<"overflow">>, reject-publish-dlx}]주의
실제로는 무시된다. 브로커 로그에만 남는다.
[warning] Invalid overflow strategy <<"reject-publish-dlx">> for quorum queue:

          queue 'orders_qq' in vhost '/'
상한을 걸었다고 믿고 있는데 걸려 있지 않은 상태다. quorum 큐에 정책을 건
뒤에는 CLI 의 성공 메시지가 아니라 브로커 로그를 확인한다.
quorum 의 reject-publish 는 상한을 정확히 지키지도 않는다. 채널에 통보가
가는 사이 이미 날아간 메시지가 있어서 몇 건 넘길 수 있다. 정밀한 상한이 필요한
자리에는 맞지 않는다.
대신 delivery-limit 을 걸 수 있다#
messages_unacknowledged 가 쌓이는 원인이 계속 실패해 재배달되는 메시지라면,
quorum 큐에는 classic 에 없는 손잡이가 있다.
rabbitmqctl set_policy qq_dl "^orders_.*$" '{"delivery-limit":5}' --apply-to queues다섯 번 배달되고도 ack 되지 않은 메시지는 큐에서 빠진다(데드레터가 있으면 그쪽
으로). 한 건이 소비자를 붙들고 무한 재시도를 도는 상황을 끊어 준다.
그대로인 것#
알람이 발행만 막고 소비는 계속된다는 것은 quorum 도 같다. 알람을 켜 놓고
quorum 큐에 발행해 확인했다.
$ rabbitmq-diagnostics -q alarms
Free disk space alarm on node rabbit@vm

$ # quorum 큐로 발행 시도 → 타임아웃

$ rabbitmqctl list_connections name state
127.0.0.1:39628 -> 127.0.0.1:5672    blocked
1·2·4·5·6장은 큐 타입과 무관하게 그대로 쓴다.
확인#
조치 뒤 이 셋이 모두 맞아야 끝난 것이다.
rabbitmq-diagnostics alarms                      # 알람 없음
rabbitmqctl list_queues name messages consumers  # 큐가 줄고 있고 consumers > 0
rabbitmqctl list_connections name state          # blocked 가 없음
consumers 가 0 이 아닌데도 messages 가 안 줄면 3장의 표로 돌아간다 —
messages_unacknowledged 를 보면 소비자가 붙어만 있고 일을 못 하는지 알 수 있다.
정리#
- 발행이 조용히 멈추면 애플리케이션이 아니라 브로커를 먼저 본다.
rabbitmq-diagnostics alarms한 줄이면 판가름 난다. - 알람은 발행만 막는다. 소비는 계속된다. 그러니 조치는 재시작이 아니라 소비자를 되살려 큐를 비우는 것이다.
messages_ready와messages_unacknowledged는 다른 병이다. 앞은 소비가 느린 것, 뒤는 소비자가 받아 놓고 ack 를 못 하는 것이다.blocked와blocking도 다르다.blocked로 뜬 주소가 지금 멈춰 있는 애플리케이션이다.set_disk_free_limit은 유예지 해결이 아니다. 재시작하면 사라지고, 디스크가 진짜 차면 노드가 죽는다.max-length+reject-publish로 상한을 걸어 둔다. 브로커 전체가 막히는 것보다 한 큐의 발행자만 실패하는 편이 낫다.- quorum 큐라면 디스크 감각을 다시 잡는다. 복제 수만큼 곱해지고, 진단 칼럼이 비고, 비워도 곧바로 줄지 않는다. 그리고
reject-publish-dlx는 성공 메시지만 주고 조용히 무시된다.

댓글