서버 한 대일 때는 이걸로 충분하다.
tail -f /var/log/app.log그런데 서버가 다섯 대가 되면? 컨테이너가 뜨고 지고 하면? 컨테이너가 죽으면
그 안의 로그도 같이 사라진다. 어제 새벽 3시에 무슨 일이 있었는지 보려면
그때 그 컨테이너가 있어야 하는데, 이미 없다.
로그를 한곳에 모아 두는 일이 필요해진다. 그 일을 하는 게 로그 수집기이고,
Fluentd 가 그중 하나다.
이 글은 Fluentd 설정 파일을 처음 보는 사람을 위한 것이다. 실제로 띄워 얻은
출력을 붙여 가며 짚는다.
참고
붙여 넣은 출력은 Fluentd 1.19.3 을 실제로 돌려 얻은 것이다.
Fluentd 가 하는 일#
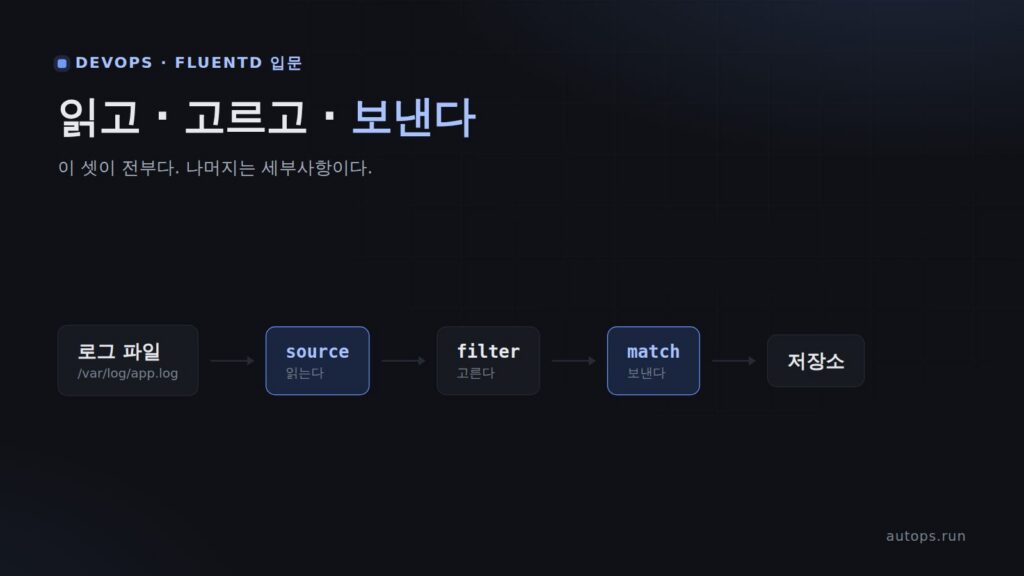
딱 세 가지다. 이것만 알면 나머지는 세부사항이다.
읽는다  →  고른다  →  보낸다
source filter match| 하는 일 | 설정 블록 | 예 |
|---|---|---|
| 읽는다 | <source> |
파일을 따라 읽기, 포트로 받기 |
| 고른다 | <filter> |
필드 추가, 민감정보 제거 (없어도 된다) |
| 보낸다 | <match> |
파일로, Elasticsearch 로, S3 로 |
<filter> 는 생략할 수 있다. <source> 와 <match> 만 있으면 돌아간다.
이벤트 하나가 어떻게 생겼나#
Fluentd 가 다루는 로그 한 줄을 이벤트라고 부르고, 세 부분으로 되어 있다.
실제 출력을 보면 바로 보인다.
2026-09-10 12:09:56.030634584 +0000 hello.world: {"message":"첫 로그"}
└──────────── 시간 ────────────┘ └── 태그 ──┘ └───── 레코드 ─────┘| 부분 | 무엇 |
|---|---|
| 시간 | 이 로그가 언제 것인가 |
| 태그 | 어디로 보낼지 정하는 이름표 |
| 레코드 | 실제 내용. JSON 이다 |
태그가 핵심이다. 우편물의 주소 같은 것이라, <match> 는 이 태그를 보고
"이건 내 것"이라고 집어 간다.
가장 작은 설정#
이게 전부다. 파일 하나에 이렇게 적는다.
<source>
  @type sample
  tag hello.world
  sample {"message":"첫 로그"}
  rate 1
</source>

<match hello.**>
  @type stdout
</match>@type— 어떤 플러그인을 쓸지.sample은 테스트용으로 가짜 로그를 만든다tag hello.world— 이 로그에 붙일 이름표<match hello.**>—hello.로 시작하는 태그를 잡아서@type stdout— 화면에 찍는다
돌려 보면 초당 한 줄씩 나온다.
$ fluentd -c 01-min.conf
2026-09-10 12:09:56.030634584 +0000 hello.world: {"message":"첫 로그"}
2026-09-10 12:09:57.033331333 +0000 hello.world: {"message":"첫 로그"}
2026-09-10 12:09:58.036052021 +0000 hello.world: {"message":"첫 로그"}팁
처음 배울 때는 무조건
@type stdout으로 시작한다. Elasticsearch 나 S3
로 바로 보내면 안 될 때 원인이 Fluentd 인지 받는 쪽인지 알 수 없다. 화면에
제대로 찍히는 것을 먼저 확인하고 목적지를 바꾼다.
태그 패턴 읽는 법#
| 패턴 | 잡는 것 |
|---|---|
app |
정확히 app 만 |
app.* |
app.error, app.access (한 단계) |
app.** |
app.error, app.error.db (몇 단계든) |
{app,web}.** |
app. 또는 web. 으로 시작하는 것 |
** |
전부 |
여기서 반드시 걸린다 — 먼저 적은 match 가 이긴다#
<match> 가 여럿이면 위에서부터 검사하고 처음 맞는 것이 가져간다. 그리고
가져간 이벤트는 아래로 내려가지 않는다.
이렇게 적으면 안 된다.
<match app.**>       # 넓은 규칙을 먼저 적었다
  @type file
  path /var/log/fluent/first
</match>

<match app.error>    # 좁은 규칙이 뒤에 있다
  @type file
  path /var/log/fluent/second
</match>
app.error 태그를 흘려 보내고 양쪽 파일을 세어 봤다.
첫 번째 match (app.**)   로 간 건수: 23
두 번째 match (app.error) 로 간 건수: 0
두 번째는 한 건도 못 받는다. app.error 는 이미 위에서 app.** 에 걸려
버렸기 때문이다.
주의
Fluentd 는 이걸 경고해 주지 않는다. 확인해 봤지만 "아래 match 는 도달할
수 없다" 같은 메시지는 나오지 않는다. 설정은 멀쩡히 뜨고, 로그만 조용히
엉뚱한 데로 간다. 좁은 규칙을 위에, 넓은 규칙을 아래에 적는다.
참고
nginx 의
location은 적은 순서가 아니라 우선순위로 고르고, 프록시의
forward규칙은 마지막에 맞은 것이 이긴다. 도구마다 반대다. 외우려 하지
말고 새 설정을 만질 때마다 확인하는 편이 낫다.
진짜 로그 파일 읽기#
sample 말고 실제 파일을 읽는다. @type tail 을 쓴다 — tail -f 와 같은 일이다.
<source>
  @type tail
  path /var/log/app.log
  pos_file /var/log/fluent/app.pos
  tag app.log
  <parse>
    @type none
  </parse>
</source>

<match app.**>
  @type stdout
</match>
@type none 은 "한 줄을 통째로 가져와라"다. 결과는 이렇다.
2026-09-10 12:10:52.516371316 +0000 app.log: {"message":"2026-09-10 12:00:01 ERROR 결제 실패 order_id=1042"}돌아는 가는데 줄 전체가 message 하나에 뭉쳐 있다. 이 상태로 모아 두면
나중에 "ERROR 만 보여 줘"를 할 수 없다.
쪼개서 읽기 — 파서#
<parse> 를 바꿔 필드를 뽑아낸다.
  <parse>
    @type regexp
    expression /^(?<time>d{4}-d{2}-d{2} d{2}:d{2}:d{2}) (?<level>w+) (?<msg>.*)$/
    time_format %Y-%m-%d %H:%M:%S
  </parse>
같은 파일이 이렇게 바뀐다.
2026-09-10 12:00:01.000000000 +0000 app.log: {"level":"ERROR","msg":"결제 실패 order_id=1042"}
2026-09-10 12:00:02.000000000 +0000 app.log: {"level":"INFO","msg":"주문 생성 order_id=1043"}
두 가지가 달라졌다.
level과msg가 따로 떨어졌다. 이제level로 걸러 낼 수 있다- 시간이
12:10:52에서12:00:01로 바뀌었다
두 번째가 특히 중요하다. 파싱하기 전에는 Fluentd 가 읽은 시각이 이벤트
시간이었다. 파싱 후에는 로그에 적힌 시각이다.
주의
이걸 놓치면 장애 분석 때 시간이 어긋난다. 수집이 밀리거나 나중에 몰아서
읽으면 실제보다 한참 뒤로 찍힌다.(?<time>...)와time_format은
빠뜨리지 않는다.
팁
로그가 이미 JSON 이면
@type json한 줄이면 되고, nginx 접근 로그라면
@type nginx가 준비돼 있다. 정규식은 마지막 수단이다.
어디까지 읽었는지 기억한다 — pos_file#
pos_file 은 어디까지 읽었는지 적어 두는 메모장이다. 안을 보면 이렇다.
/var/log/app.log    000000000000006b    00000000001d05dd
└──── 파일 ────┘   └── 읽은 위치 ──┘   └─ inode ─┘
덕분에 Fluentd 를 껐다 켜도 처음부터 다시 읽지 않는다. 확인해 봤다.
$ # pos_file 을 그대로 두고 다시 띄우면
읽은 이벤트 수: 0

$ # 로그를 한 줄 추가하고 다시 띄우면
2026-09-10 12:00:03 +0000 app.log: {"level":"WARN","msg":"재고 부족 order_id=1044"}
새로 추가된 줄만 읽는다.
주의
pos_file을 안 적으면 재시작할 때마다 파일을 처음부터 다시 읽어 로그가
중복된다. 빠뜨리기 쉬운데 결과는 조용히 나빠서, 며칠 뒤 "왜 같은 로그가
여러 번 있지?" 로 발견된다.
보낼 곳이 죽으면 어떻게 되나 — 버퍼#
가장 궁금해할 것이다. 로그가 사라지지 않는다. Fluentd 는 보내기 전에
버퍼에 쌓아 두고, 실패하면 재시도한다.
아무도 안 듣는 포트로 보내 봤다.
[warn]: failed to flush the buffer. retry_times=0 next_retry_time=2026-09-10 12:11:58 ...
[warn]: failed to flush the buffer. retry_times=1 next_retry_time=2026-09-10 12:11:59 ...
그동안 버퍼 파일이 쌓인다.
$ ls buf/
buffer.b65b1fdfc673abc8e4e3fb95f56987917.log
buffer.b65b1fdfc673abc8e4e3fb95f56987917.log.meta
받는 쪽이 살아나면 쌓아 둔 것부터 보낸다.
<match app.**>
  @type forward
  <server>
    host log-server.example.com
    port 24224
  </server>
  <buffer>
    @type file              # 디스크에 쌓는다
    path /var/log/fluent/buf
    flush_interval 5s       # 5초마다 보낸다
    retry_max_times 5       # 5번까지 재시도
  </buffer>
</match>팁
@type file로 둔다. 기본값인 메모리 버퍼는 Fluentd 가 죽으면 쌓아 둔
로그도 같이 사라진다. 디스크 버퍼는 재시작해도 남는다.
주의
버퍼는 무한하지 않다. 받는 쪽이 오래 죽어 있으면 버퍼가 디스크를 채우고,
그 뒤로는 버린다. 버퍼 디렉터리 크기를 감시 대상에 넣어 둔다.
확인#
설정을 고쳤으면 문법부터 본다. --dry-run 은 실제로 돌리지 않고 검사만 한다.
fluentd -c fluent.conf --dry-run문제가 있으면 어디가 잘못됐는지 짚어 준다.
[error]: config error file="fluent.conf" error_class=Fluent::ConfigError
         error="<parse> section is required."
종료 코드도 제대로 낸다 — 정상이면 0, 설정 오류면 1 이다. 배포 스크립트에서
반영 전에 걸러 내기 좋다.
fluentd -c fluent.conf --dry-run && systemctl reload fluentd돌려 놓고 로그가 안 들어오면 이 순서로 좁힌다.
| 증상 | 볼 곳 |
|---|---|
| 아무것도 안 나온다 | <source> 의 path 가 맞나. Fluentd 가 그 파일을 읽을 권한이 있나 |
| 읽기는 하는데 안 나간다 | 태그와 <match> 패턴이 맞나 |
| 엉뚱한 곳으로 간다 | 위쪽 <match> 가 먼저 채 갔다 |
| 같은 로그가 여러 번 | pos_file 이 없다 |
| 시간이 이상하다 | 파서에 time 과 time_format 이 없다 |
의심스러우면 <match> 를 @type stdout 으로 바꿔 본다. 화면에 나오면
Fluentd 까지는 정상이고 문제는 목적지에 있다.
Fluentd 와 Fluent Bit#
같이 나오는 이름이라 한 줄로 정리한다.
| Fluentd | Fluent Bit | |
|---|---|---|
| 만든 언어 | Ruby (+C) | C |
| 메모리 | 수십 MB | 수 MB |
| 플러그인 | 아주 많다 | 상대적으로 적다 |
| 잘 맞는 자리 | 중앙에서 모아 가공 | 각 서버·컨테이너에서 걷어 보내기 |
둘은 경쟁 관계가 아니라 짝으로 자주 쓰인다. 각 노드에 가벼운 Fluent Bit 을
두고, 중앙의 Fluentd 로 모아 가공한 뒤 저장소로 보내는 구성이 흔하다.
정리#
- Fluentd 는 읽고 → 고르고 → 보낸다.
<source>와<match>만 있으면 돌아간다. - 이벤트는 시간·태그·레코드 셋이다. 태그가 곧 배달 주소다.
- 먼저 적은
<match>가 이기고, 경고도 없다. 좁은 규칙을 위에 적는다. - 파싱은 필드를 나누는 일이자 시간을 바로잡는 일이다.
time을 안 뽑으면 로그가 읽은 시각으로 찍힌다. pos_file을 빠뜨리면 재시작마다 중복된다.- 버퍼는 파일로 둔다. 메모리 버퍼는 프로세스와 함께 사라진다.
- 막히면
@type stdout. Fluentd 문제인지 목적지 문제인지 가르는 가장 빠른 길이다.
함께 읽기#
- RabbitMQ 가 발행을 막을 때 — 버퍼가 쌓여 디스크를 채우면 무슨 일이 생기는지. Fluentd 의 파일 버퍼도 같은 위험을 안고 있다.
- nginx 처음 만지기 — Fluentd 로 모을 첫 로그는 대개 웹 서버 접속 로그다.

댓글