앞 편에서 요청을 큐에 넘겼다. 사용자는 이제 기다리지 않는다.
그런데 실패는 어떻게 되고 있을까. 재 봤다.
응답 없는 주소  → status=failed  error=가져오지 못했습니다: <urlopen error timed out>  (8.2s)
없는 페이지 404 → status=failed  error=HTTP 404  (0.5s)
kubectl exec -n linkcard rabbitmq-0 -- rabbitmqctl list_queues name messagescard.jobs 0실패하면 그걸로 끝이다. 다시 해 보지도 않고, 어디에도 흔적이 남지 않는다. 상대 서버가
잠깐 버벅인 것뿐이었어도 사용자는 실패 메시지를 받는다.
이번 편은 이걸 고친다. 그리고 그 과정에서 워커가 죽으면 작업이 어떻게 되는지 직접 죽여 보며 확인한다.
이 편에서 만드는 것#
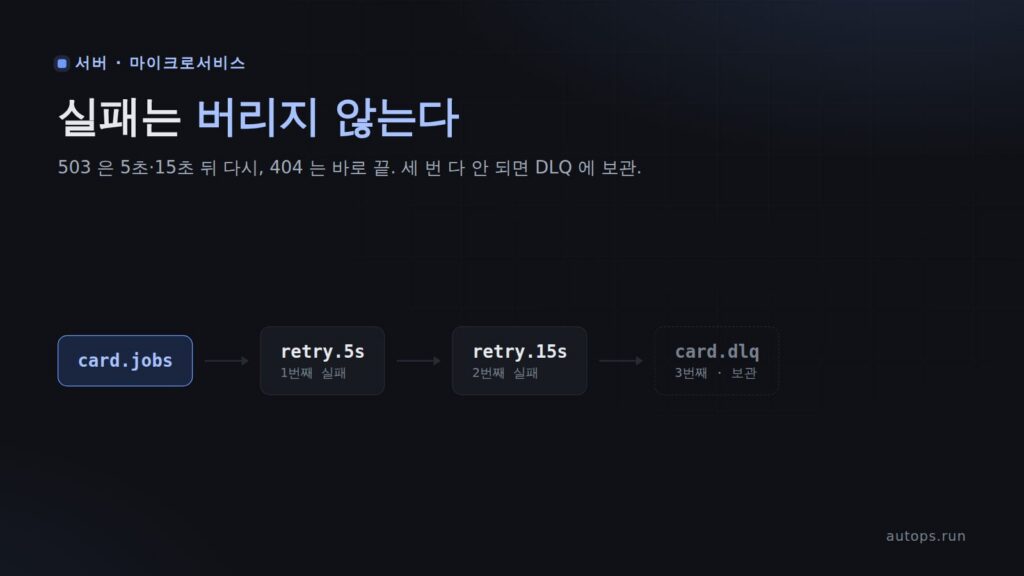
                  실패           5초 묵힘
card.jobs ─────────────▶ card.retry.5s ──────────┐
    ▲                                            │
    └────────────────────────────────────────────┘
                  또 실패         15초 묵힘
card.jobs ─────────────▶ card.retry.15s ─────────┐
    ▲                                            │
    └────────────────────────────────────────────┘
                  세 번째도 실패
card.jobs ─────────────▶ card.dlq (사람이 볼 때까지 보관)| 실패 | 처리 |
|---|---|
| 타임아웃, 503 같은 5xx, 429 | 다시 한다. 5초 뒤, 15초 뒤. 세 번 다 실패하면 DLQ |
| 404, 잘못된 주소 | 바로 끝낸다. 몇 번을 해도 같다 |
| 읽을 수조차 없는 메시지 | DLQ 에 격리한다. 큐를 막지 않게 |
참고
DLQ(Dead Letter Queue) 는 "처리하지 못한 메시지를 따로 모아 두는 큐"다. 우리말로는
흔히 '데드레터 큐' 라고 부른다. 소비자를 붙이지 않고 두었다가, 사람이 들여다보고
원인을 찾거나 다시 넣는다.
1. 실패를 두 종류로 나눈다#
재시도의 첫 단추는 "다시 하면 될 실패인가" 를 가르는 것이다. 404 를 세 번 다시 요청해
봐야 세 번 다 404 다. 괜히 상대 서버에 부담만 준다.
카드를 만드는 함수가 실패할 때 retryable 을 함께 돌려주게 했다.
except HTTPError as e:
    # 5xx 와 429(너무 많은 요청)는 상대 서버 사정이다. 잠시 뒤엔 될 수 있다.
    # 404·403 같은 나머지 4xx 는 몇 번을 다시 해도 같다.
    retry = e.code >= 500 or e.code == 429
    return {"ok": False, "retryable": retry, "code": f"http_{e.code}",
            "error": f"HTTP {e.code}"}
except (URLError, TimeoutError) as e:
    # 타임아웃·연결 실패. 일시적인 네트워크 문제일 수 있으니 재시도한다.
    return {"ok": False, "retryable": True, "code": "network",
"error": f"가져오지 못했습니다: {e}"}팁
이 기준은 내가 정한 것이다. 예를 들어 "없는 도메인" 도 연결 실패로 잡혀 재시도 대상이
되는데, 사실 몇 번을 해도 안 된다. 서비스마다 기준은 다를 수 있다. 중요한 건
기준을 코드에 명시적으로 두는 것이다.
2. 먼저 확인할 것 — ack 가 실제로 무엇을 지켜 주나#
재시도를 짜기 전에, 앞 편에서 넣어 둔 basic_ack 가 정말 작업을 지켜 주는지 확인했다.
앞 편의 워커는 처리가 다 끝난 뒤에 ack 를 보낸다.
result = build_card(url)          # 8초가 걸릴 수도 있는 일
report(job_id, result)
ch.basic_ack(method.delivery_tag) # 여기서야 "다 했다"참고
ack(acknowledgement) 는 "이 메시지 처리 끝났으니 지워도 된다" 는 신호다.
RabbitMQ 는 ack 를 받기 전까지 메시지를 지우지 않는다. 워커가 ack 없이 연결이 끊기면,
그 메시지를 다른 워커에게 다시 준다. 이론은 그렇다. 실제로 그런지 본다.
8초가 걸리는 작업을 넣고, 워커가 그걸 집어 간 직후에 워커 파드를 지웠다. 두 가지 방법으로.
평범하게 내렸을 때 — 31.2초#
배포하거나 파드 수를 줄일 때 쿠버네티스가 하는 방식이다.
kubectl delete pod <작업 중인 워커>작업 bbac12ac 을 4ztxz 가 집어 감 (+0.6s), grace=30s
파드 삭제 (일반 SIGTERM)
원래 파드가 사라지기까지 : 31.2s
원래 파드가 작업을 끝냄 : +7.8s
다른 워커가 다시 받음 : 아니오
최종 상태 : failed 가져오지 못했습니다: <urlopen error timed out>작업은 사라지지 않았다. 지워지는 파드가 작업을 끝까지 마쳤다. 그런데 파드가 사라지는 데
31.2초가 걸렸다. 작업은 7.8초에 끝났는데 말이다.
이유는 컨테이너 안에서 어떤 프로세스가 1번인지 보면 나온다.
kubectl exec -n linkcard <워커파드> -- sh -c 'tr "" " " < /proc/1/cmdline'python -u app.py주의
python 이 PID 1 이면 SIGTERM 을 무시한다. 리눅스는 PID 1 번 프로세스에게 신호의
기본 동작(종료)을 적용하지 않는다. 처리기를 직접 달아 두지 않으면 신호가 와도 아무 일도
일어나지 않는다.쿠버네티스는 파드를 내릴 때 SIGTERM 을 보내고
terminationGracePeriodSeconds(기본 30초)
만큼 기다린다. 그래도 안 죽으면 SIGKILL 로 강제로 죽인다. 그 30초를 꼬박 기다린 것이다.이번엔 작업이 8초라 운 좋게 끝났다. 30초보다 긴 작업이었다면 중간에 잘렸다.
그리고 배포할 때마다 워커 하나당 30초씩 버려진다.
강제로 죽였을 때 — 사라지진 않았다, 다만 1분 넘게 걸렸다#
크래시나 메모리 초과(OOM)로 프로세스가 갑자기 죽는 상황을 흉내 냈다.
kubectl delete pod <작업 중인 워커> --grace-period=0 --force작업 a563c90b 을 7bcvm 가 집어 감 (+0.5s), grace=30s
파드 삭제 (강제 SIGKILL)
원래 파드가 사라지기까지 : 0.1s
원래 파드가 작업을 끝냄 : 아니오
다른 워커가 다시 받음 : 아니오
최종 상태 : queued파드는 0.1초 만에 사라졌는데, 다른 워커가 받지 않았다. 20초가 넘게 queued 그대로였다.
작업이 사라진 줄 알았다.
잠시 뒤 다시 보니 끝나 있었다.
상태        : failed
total_wait  : 71.36 초  (접수 → 최종 결과 보고까지)
[worker-dwv8f] 시작 job=a563c90b27dd url=http://10.255.255.1/
[worker-dwv8f] 완료 job=a563c90b27dd ok=False elapsed=8.03s죽은 파드를 대신해 새로 뜬 워커가 다시 받아 처리했다. 작업은 사라지지 않았다.
다만 전체 71.36초에서 작업 시간 8.03초를 빼면, 강제 종료하고 1분 넘게 지나서야 다시 시작됐다.
왜 이렇게 오래 걸렸는지는 뒤에서 한 번 더 재서 확인한다. 우선 결론은 이렇다.
- ack 를 처리 뒤에 보내면 작업은 사라지지 않는다. 두 경우 모두 확인했다.
- 대신 평범한 종료는 30초를 버리고, 강제 종료는 1분 넘게 늦게 돌아온다.
3. 재시도 큐 — TTL 과 데드레터를 엮는다#
RabbitMQ 에는 "몇 초 뒤에 다시 줘" 라는 기능이 기본으로는 없다. 지연 전용 플러그인이 있긴
하지만, 기본 기능 둘을 엮으면 플러그인 없이 된다.
- TTL — 메시지가 큐에 머물 수 있는 시간. 지나면 만료된다.
- 데드레터 — 만료된 메시지를 버리지 않고 지정한 곳으로 보내는 설정.
둘을 합치면 이렇게 된다. 소비자가 없는 큐에 메시지를 넣어 두면 아무도 안 꺼내 가니
TTL 만큼 머물다 만료되고, 데드레터 설정에 따라 원래 큐로 돌아간다. 그게 "5초 뒤 재시도" 다.
def declare_topology(ch):
    ch.queue_declare(queue="card.jobs", durable=True)
    ch.queue_declare(queue="card.dlq",  durable=True)
    for delay in [5, 15]:
        ch.queue_declare(
            queue=f"card.retry.{delay}s", durable=True,
            arguments={
                "x-message-ttl": delay * 1000,            # 이만큼 묵힌 뒤
                "x-dead-letter-exchange": "",             # 기본 교환기를 거쳐
                "x-dead-letter-routing-key": "card.jobs", # 원래 큐로 돌려보낸다
            })
배포한 뒤 큐가 실제로 그렇게 만들어졌는지 본다.
kubectl exec -n linkcard rabbitmq-0 --
  rabbitmqctl list_queues name messages consumers arguments
card.dlq 0 0 [{"x-queue-type","classic"}]
card.retry.15s 0 0 [{"x-dead-letter-exchange",[]},{"x-dead-letter-routing-key","card.jobs"},{"x-message-ttl",15000},{"x-queue-type","classic"}]
card.retry.5s 0 0 [{"x-dead-letter-exchange",[]},{"x-dead-letter-routing-key","card.jobs"},{"x-message-ttl",5000},{"x-queue-type","classic"}]두 재시도 큐 모두 소비자가 0 이다. 그래야 한다.
워커 — 넣고 나서 ack 한다#
if result.get("retryable") and attempt < MAX_ATTEMPTS:
    delay = RETRY_DELAYS[attempt - 1]
    # ① 재시도 큐에 먼저 넣고
    publish(ch, f"card.retry.{delay}s", body, {**headers, "x-attempt": attempt + 1})
    report(job_id, {**result, "status": "retrying", "next_retry_in": delay})
    # ② 그다음 원본을 ack 한다
    ch.basic_ack(method.delivery_tag)
    return
순서가 중요하다. ack 를 먼저 하고 재시도 큐에 넣으면, 그 사이에 워커가 죽었을 때
원본은 이미 지워졌고 재시도 메시지는 아직 없다. 작업이 통째로 사라진다.
이 순서라면 최악의 경우 넣고 나서 ack 전에 죽는다. 원본이 되살아나고 재시도 메시지도 있으니
같은 작업이 한 번 더 돈다. 사라지는 것보다는 두 번 도는 게 낫다.
참고
이렇게 "최소 한 번은 처리되지만, 두 번 처리될 수도 있다" 는 성질을
at-least-once(최소 한 번) 라고 부른다. 메시지 큐를 쓰면 대부분 이쪽이다.
그래서 작업은 두 번 돌아도 결과가 같게 만들어 두는 게 좋다. 카드 만들기는 같은 주소면
같은 카드가 나오니 괜찮다.
끝낼 때 — DLQ 에 넣을 것과 안 넣을 것#
if result.get("retryable"):
    # 재시도를 다 썼다. 처리하지 못한 작업이니 DLQ 에 보관한다.
    publish(ch, "card.dlq", body, {**headers, "x-reason": "max_attempts"})
else:
    # 404 같은 것. 처리는 제대로 했고 답이 "없는 페이지" 일 뿐이다.
    report(job_id, {**result, "status": "failed"})
ch.basic_ack(method.delivery_tag)
404 는 DLQ 에 넣지 않았다. DLQ 는 '처리하지 못한 것' 을 두는 곳이지 '결과가 실패인 것'
을 두는 곳이 아니다. 404 는 처리를 잘 해서 "없다" 는 답을 얻은 것이다. 이걸 DLQ 에 넣기
시작하면 정말 들여다봐야 할 메시지가 파묻힌다.
4. 재 본다#
화면에서도 재시도가 보이게 했다.
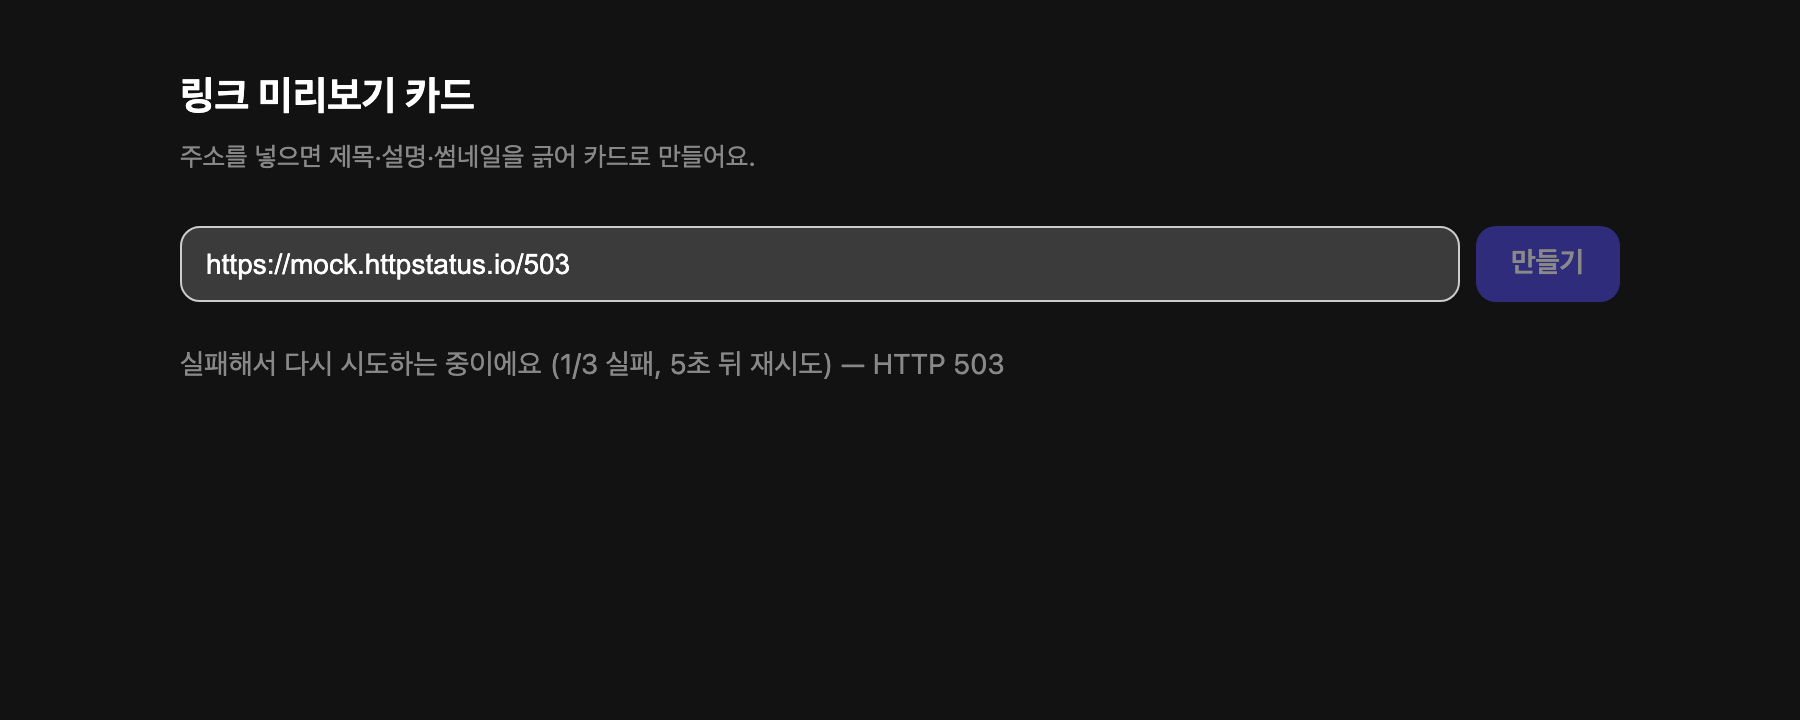
세 경우를 넣고 상태가 바뀌는 순간을 기록했다.
503 — 재시도 대상, 응답은 빠르다
접수 49ms
+  0.0s  queued   attempt=None
+  0.5s  retrying attempt=1  다음 재시도 5초 뒤  HTTP 503
+  6.0s  retrying attempt=2  다음 재시도 15초 뒤  HTTP 503
+ 21.2s  failed   attempt=3  DLQ=True  HTTP 503
최종: failed  시도 3/3  total_wait=21.16초  dead_lettered=True
첫 실패 뒤 5.5초, 두 번째 실패 뒤 15.2초 만에 다시 시도했다. 설정한 5초·15초에
처리 시간이 조금 얹힌 값이다.
404 — 재시도 안 함
접수 49ms
+  0.0s  queued   attempt=None
+  1.1s  failed   attempt=1  DLQ=False  HTTP 404
최종: failed  시도 1/3  total_wait=0.87초  dead_lettered=False
한 번 만에 끝났다. DLQ 에도 가지 않았다.
응답 없는 주소 — 재시도 대상, 매번 8초 타임아웃
접수 16ms
+  0.0s  queued   attempt=None
+  8.2s  retrying attempt=1  다음 재시도 5초 뒤
+ 21.1s  retrying attempt=2  다음 재시도 15초 뒤
+ 44.3s  failed   attempt=3  DLQ=True
최종: failed  시도 3/3  total_wait=44.05초  dead_lettered=True
8초 + 5초 + 8초 + 15초 + 8초 = 44초. 계산대로다.
주의
재시도는 공짜가 아니다. 응답 없는 주소 하나가 이제 8초가 아니라 44초 동안 워커를
세 번 붙잡는다. 이런 주소가 몰려 들어오면 워커가 재시도에 묶여 새 작업이 밀린다.
재시도 횟수와 간격은 "몇 번이면 살아날 가능성이 있나" 와 "그동안 얼마나 묶여도 되나" 를
함께 보고 정해야 한다.
워커 로그로 보면 흐름이 더 잘 보인다.
[df6xk] 시작 job=7daacbb264f3 attempt=1/3 url=https://mock.httpstatus.io/503
[df6xk] 재시도 예약 job=7daacbb264f3 attempt=1 → 5초 뒤 error=HTTP 503
[df6xk] 시작 job=7daacbb264f3 attempt=2/3 url=https://mock.httpstatus.io/503
[df6xk] 재시도 예약 job=7daacbb264f3 attempt=2 → 15초 뒤 error=HTTP 503
[8jm6p] 시작 job=7daacbb264f3 attempt=3/3 url=https://mock.httpstatus.io/503
[8jm6p] 포기 job=7daacbb264f3 attempt=3 → DLQ
[8jm6p] 시작 job=f38f9361be6b attempt=1/3 url=https://httpbin.org/status/404
[8jm6p] 실패(재시도 안 함) job=f38f9361be6b code=http_404
같은 작업의 세 번째 시도는 다른 워커(8jm6p) 가 했다. 재시도 메시지는 원래 큐로 돌아가니
어느 워커든 받을 수 있다.
5. DLQ 를 들여다본다#
DLQ 에 뭐가 쌓였는지 본다. 꺼냈다가 그대로 되돌려 놓는 방식으로 본다.
그냥 꺼내면(auto_ack) 사라지니 주의한다.
m, props, body = ch.basic_get("card.dlq", auto_ack=False)   # 꺼내되 지우지 않는다
print(body, props.headers)
ch.basic_nack(delivery_tag=m.delivery_tag, requeue=True)     # 그대로 되돌린다
--- 1 ---
job=7daacbb264f3 url=https://mock.httpstatus.io/503
x-reason = max_attempts
x-attempt = 3
x-last-error = HTTP 503
x-death : queue=card.retry.15s reason=expired count=1왜 여기 왔는지(x-reason), 몇 번 해 봤는지(x-attempt), 마지막 오류가 뭐였는지
(x-last-error)가 붙어 있다. 사람이 원인을 찾을 때 이게 있어야 한다.
팁
x-death는 RabbitMQ 가 데드레터를 할 때 스스로 붙이는 기록이다. 그런데 보면
마지막 재시도 큐(card.retry.15s) 하나만 남아 있다. 5초 재시도 기록은 없다.
워커가 메시지를 다시 발행하는 과정에서 앞의 기록이 이어지지 않았다.그래서 재시도 횟수를
x-death의 count 로 세지 않고,x-attempt헤더를 직접 올려 가며
센다.x-death만 믿고 짰다면 횟수가 매번 1 로 보여 무한히 재시도했을 것이다.
6. 독 메시지 — 읽을 수조차 없는 것#
JSON 이 깨진 메시지가 들어오면 어떻게 될까. web 을 거치지 않고 큐에 직접 넣었다.
발행: {"job_id": "poison-1", "url": ← 닫히지 않은 JSON[worker-8jm6p] 읽을 수 없는 메시지 → DLQlinkcard-worker-7b9cb46788-8jm6p 재시작 0 Running
linkcard-worker-7b9cb46788-df6xk 재시작 0 RunningDLQ 에는 본문 그대로 보관됐다.
--- 3 ---
본문=b'{"job_id": "poison-1", "url": '
x-reason = unparseable주의
이런 메시지를 독 메시지(poison message) 라고 부른다. 처리하다 예외가 나서 ack 없이
끝나면 RabbitMQ 가 되돌려 놓고, 워커가 또 받아 또 실패한다. 같은 메시지를 영원히
되풀이하며 큐를 막는다. 다시 넣어 봐야 소용없는 메시지는 반드시 빼내야 한다.
버리지 말고 DLQ 로 보내 두면, 어디서 이런 게 왔는지 나중에 찾을 수 있다.
7. 30초를 없앤다 — SIGTERM 처리기#
2단계에서 본 31.2초를 없앤다. 워커가 SIGTERM 을 직접 받게 한다.
def _on_sigterm(signum, frame):
    global _stopping
    _stopping = True
    print("[worker] SIGTERM 받음 — 하던 작업만 끝내고 종료", flush=True)
    # 신호 처리기 안에서 pika 를 직접 만지지 않는다.
    # 루프가 안전한 시점에 멈추도록 부탁만 한다.
    _connection.add_callback_threadsafe(_request_stop)


signal.signal(signal.SIGTERM, _on_sigterm)참고
왜 바로 멈추지 않고 "부탁" 하나. 신호는 코드가 어디를 실행하든 끼어든다. pika 가
메시지를 주고받는 한가운데일 수도 있다. 거기서 연결을 건드리면 상태가 꼬인다.
add_callback_threadsafe는 "다음에 루프가 한숨 돌릴 때 이걸 불러 줘" 라는 뜻이라 안전하다.
그리고 지금 처리 중인 작업은 끝까지 가고 ack 까지 한 뒤에 멈춘다.
다시 내려 봤다.
=== A. 쉬는 워커를 내린다 ===
삭제 → SIGTERM 로그 :   0.2s
삭제 → '종료' 로그  :   0.2s
삭제 → 파드 사라짐  :   0.7s   (핸들러 없던 때는 31.2s)
=== B. 작업 중인 워커를 내린다 (8초 작업 2초 지점) ===
삭제 → SIGTERM 로그 : 0.2s
삭제 → '종료' 로그 : 6.1s
삭제 → 파드 사라짐 : 6.7s (핸들러 없던 때는 31.2s)
│ 시작 job=56d431f57407 attempt=1/3 url=http://10.255.255.1/
│ SIGTERM 받음 — 하던 작업만 끝내고 종료
│ 재시도 예약 job=56d431f57407 attempt=1 → 5초 뒤 error=가져오지 못했습니다
│ 종료
그 작업의 상태 : retrying attempt=1 next_retry_in=5쉬는 워커는 0.7초, 작업 중인 워커는 남은 6초를 마저 일하고 6.7초에 나갔다.
하던 작업은 잘리지 않고 재시도 큐로 넘어갔다. 로그 순서가 그걸 보여 준다 —
SIGTERM 받음 → 재시도 예약 → 종료.
팁
작업이
terminationGracePeriodSeconds(기본 30초)보다 길 수 있다면 이 값도 늘려야 한다.
처리기가 있어도 30초가 지나면 SIGKILL 이 온다.
8. 강제 종료는 왜 1분이 넘게 걸렸나#
2단계에서 강제 종료한 작업이 1분 넘게 늦게 돌아온 이유를 다시 재서 확인했다.
이번엔 강제 종료 5초 뒤 RabbitMQ 의 연결 목록을 같이 봤다.
=== C. 작업 중인 워커를 강제 종료 (파드 IP 10.244.16.189) ===
강제 종료 5초 뒤 RabbitMQ 연결 :
 │ 10.244.16.189	running	30   ← 죽은 파드의 연결이 아직 남아 있다
 │ 10.244.120.142	running	30
 │ 10.244.16.190	running	30
다시 받은 워커  : lwfn9
강제 종료 → 재전달 : 로그 기준 72.9s
재전달 뒤 연결 :
 │ 10.244.120.142	running	30
 │ 10.244.16.190	running	30
파드는 이미 없는데 RabbitMQ 는 그 연결이 살아 있다고 여기고 있었다. 연결이 목록에서
사라진 뒤에야 메시지가 다른 워커에게 갔다. 이번엔 72.9초가 걸렸다.
참고
왜 모르나. 평범하게 끝나는 프로세스는 연결을 닫겠다고 상대에게 알린다. 강제로 죽으면
그 인사를 못 하고 사라진다. 파드의 네트워크까지 통째로 없어지니 RabbitMQ 쪽에는
아무 신호도 가지 않는다.그래서 RabbitMQ 는 heartbeat 로 확인한다. 연결이 살아 있는지 주기적으로 신호를
주고받는데, 그 신호가 끊긴 걸 확인하고서야 "죽었구나" 하고 연결을 닫는다. 위 출력의
세 번째 칸30이 그 heartbeat 설정(초)이다. 두 번 재서 모두 1분 넘게(62.8초, 72.9초) 걸렸다.
팁
heartbeat 를 짧게 잡으면 죽은 워커를 빨리 알아챈다. 대신 네트워크가 잠깐 느려지기만 해도
멀쩡한 연결을 죽은 걸로 오해해 끊을 수 있다. 짧게 잡는다고 무조건 좋은 게 아니다.
평범한 종료에서는 SIGTERM 처리기로 연결을 제대로 닫으니 이 기다림 자체가 생기지 않는다.
여기서 한 번 더 막혔다 — 배포가 안 된 줄 알았다#
재시도 코드를 커밋하고 동기화를 기다리는 스크립트를 돌렸는데, 결과가 이상했다.
동기화: Succeeded  (리비전 9ad8948)
linkcard-web  linkcard-web:v6
linkcard-worker  linkcard-worker:v1
내가 올린 커밋은 cbf571b 인데 ArgoCD 는 옛 커밋 9ad8948 로 동기화했다고 하고, 이미지도 옛
버전이었다. 그런데 워커 로그에는 새 코드가 떠 있었다.
ArgoCD 의 동기화 이력을 보니 멀쩡했다.
id=7   9ad8948  2026-09-14T16:16:43Z
id=8   cbf571b  2026-09-14T22:54:37Z
원인은 내 확인 스크립트였다. 동기화를 요청하자마자 operationState.phase 가 Succeeded
인지 봤는데, 그건 직전 동기화(id=7)의 결과였다. 새 동기화가 시작되기도 전에 "끝났다" 고
읽고 빠져나온 것이다. 몇 초 뒤 실제 동기화가 돌며 새 버전으로 바뀌었다.
주의
ArgoCD 에 동기화를 요청한 직후
phase만 보고 판단하면 이전 결과를 읽는다.
확인하려면status.sync.revision이 내가 올린 커밋 해시와 같아졌는지를 봐야 한다.
ArgoCD 를 붙이는 과정은 kind 클러스터에 ArgoCD 올리기에 따로 정리해 두었다.
정리#
- 실패를 두 종류로 나눈다. 타임아웃·5xx·429 는 다시 하고, 404 같은 건 바로 끝낸다. 404 를 세 번 다시 해 봐야 세 번 다 404 다.
- ack 를 처리 뒤에 보내면 워커가 죽어도 작업은 사라지지 않는다. 평범한 종료에서도, 강제 종료에서도 확인했다.
- 재시도는 플러그인 없이 TTL + 데드레터로 만든다. 소비자 없는 큐에 넣어 두면 TTL 뒤 원래 큐로 돌아온다. 재시도 큐에 먼저 넣고 원본을 ack 해야 사이에 죽어도 안 사라진다.
- DLQ 는 '처리하지 못한 것' 만 둔다. 재시도를 다 쓴 것과 읽을 수 없는 독 메시지. 이유·횟수·마지막 오류를 헤더에 붙여 둔다. 횟수는
x-death가 아니라 직접 센다. - python 이 PID 1 이면 SIGTERM 을 무시한다. 파드를 내리는 데 31.2초가 걸렸다. 처리기를 달자 0.7초, 작업 중이어도 하던 일만 끝내고 6.7초에 나갔다.
- 강제로 죽은 워커의 작업은 heartbeat 로 알아챌 때까지 돌아오지 않는다. 두 번 재서 62.8초, 72.9초. 평범한 종료를 제대로 처리해 두는 게 그래서 중요하다.
다음 편은 로그다. 지금 이 과정을 따라가려면 kubectl logs 를 파드마다 쳐야 했다. 워커가 둘이고
재시도는 다른 워커가 받기도 하니, 한 작업의 흐름을 보려면 여기저기 뒤져야 한다. 흩어진 로그를 한곳에 모은다.

댓글