앞 편에서 web 과 fetcher 두 서비스를 올렸다.
잘 돈다. 주소를 넣으면 카드가 만들어진다.
이번 편은 잘 도는 것처럼 보이는 이 구성이 어디서 무너지는지 재 본다.
다음 편에서 메시지 큐를 넣는 이유가 여기서 나온다.
먼저 평소 속도를 잰다#
여섯 개 사이트로 카드를 만들어 봤다.
대상                              총      페이지    이미지    합성     카드
--------------------------------------------------------------------------
https://kubernetes.io/           0.39s    0.06s    0.22s    0.08s    43KB
https://github.com/              0.28s    0.08s    0.12s    0.05s    74KB
https://www.python.org/          0.06s    0.04s    0.00s    0.01s    20KB
https://news.ycombinator.com/    0.61s    0.58s    0.00s    0.02s    14KB
https://grafana.com/             0.92s    0.57s    0.26s    0.06s    79KB
https://www.docker.com/          0.19s    0.09s    0.04s    0.04s    52KB

평균 0.41초, 최대 0.92초
빠르다. 솔직히 나는 이걸 재기 전까지 "크롤링은 느리니까 큐가 필요하다" 고
생각하고 있었다. 틀렸다. 요즘 사이트는 빠르고, 이미지도 수십 KB 라 금방 받는다.
참고
단계를 나눠 찍어 둔 이유가 있다. 어디가 느린지 모르면 고칠 수 없다.
위 표를 보면render(카드 합성)는 어느 경우에도 0.1초를 넘지 않는다.
시간을 먹는 건 거의 다 바깥 사이트를 기다리는 쪽이다.
그럼 이대로 두면 되나? 아니다.
죽은 주소를 넣어 본다#
응답하지 않는 주소를 하나 넣어 봤다.
http://10.255.255.1/ 8.02초 실패8초를 기다렸다가 실패 메시지를 받는다. 코드에 타임아웃을 8초로 잡아 뒀기
때문이다. 그 8초 동안 이 요청은 서버 자리 하나를 붙잡고 있다.
평균 0.41초인 서비스에 8초짜리가 섞여 있다. 이걸 꼬리 지연(tail latency)
이라고 부른다. 평균 뒤에 숨어 있는 최악의 경우다.
참고
왜 타임아웃을 두나. 안 두면 영원히 기다린다. 상대 서버가 응답을 안 주고
연결만 열어 두면 요청이 끝나지 않는다. 그래서 반드시 둔다. 다만 타임아웃을
두면 그 시간만큼은 반드시 붙잡힌다는 뜻이기도 하다.
여기가 핵심이다 — 남의 요청이 내 요청을 막는다#
서버는 요청을 무한정 동시에 처리하지 못한다. fetcher 는 gunicorn 워커 2개로
돌고 있다. 동시에 2개까지만 처리한다는 뜻이다.
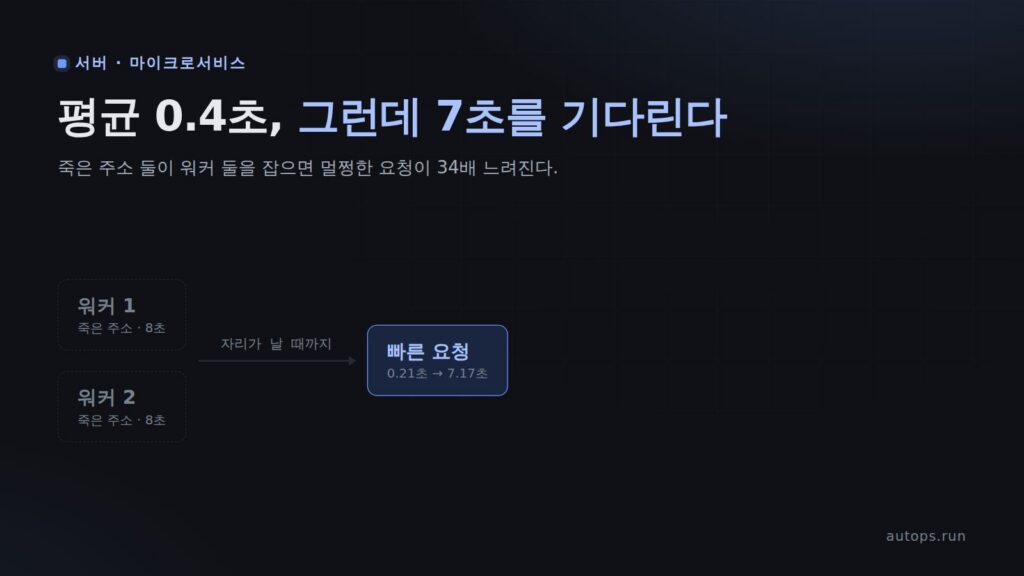
CMD ["gunicorn", "-w", "2", "-k", "sync", ...]죽은 주소 2개를 먼저 넣어 워커 둘을 붙잡아 놓고, 그 상태에서 멀쩡한 사이트를
요청해 봤다.
평상시 빠른 요청      : 0.21초

느린 요청 2개가 워커 2개를 점유한 상태에서
  빠른 요청 응답      : 7.17초
  느려진 배수         : 34.6배
34배다. 0.2초면 끝날 요청이 7초를 기다렸다. 이 사용자는 잘못한 게 없다.
그냥 남이 넣은 죽은 주소 뒤에 줄을 섰을 뿐이다.
더 넣으면 더 나빠진다. 죽은 주소 4개와 빠른 요청 3개를 함께 넣었다.
빠른 요청 3개 : 7.19초 / 7.34초 / 15.38초
최악 지연     : 74배
한 명은 15초를 기다렸다.
주의
이 문제는 평균만 보면 절대 안 보인다. 위 실험에서도 대부분의 요청은
0.2초에 끝난다. 모니터링 화면의 평균 응답시간은 멀쩡해 보인다. 그런데
어떤 사용자는 15초를 기다리다 창을 닫는다.그래서 응답시간은 평균이 아니라 p95·p99 같은 백분위로 봐야 한다.
왜 이렇게 되나 — 자리가 정해져 있기 때문#
그림으로 보면 단순하다.
워커 1 ──[ 죽은 주소 · 8초 점유 ]───────────────────▶
워커 2 ──[ 죽은 주소 · 8초 점유 ]───────────────────▶
                                    ↑
빠른 요청 ─────── 여기서 대기 ──────┘  (자리가 날 때까지)
워커가 2개니 동시에 2건이다. 그 2건이 8초를 잡고 있으면 세 번째 요청은
줄을 서야 한다. 처리 시간이 0.2초든 말든 상관없다.
팁
"그럼 워커를 늘리면 되지 않나?" 늘리면 더 오래 버틴다. 하지만 해결은
아니다. 워커를 20개로 늘려도 죽은 주소 20개가 들어오면 똑같아진다.
메모리도 그만큼 더 쓴다. 자리 수를 늘리는 건 시간을 버는 것이지
문제를 없애는 게 아니다.
개발 서버로 재면 이 문제가 안 보인다#
처음에 나는 Flask 개발 서버로 돌리고 있었다. 그때 같은 실험을 하면 이렇게 나온다.
느린 요청 8개가 도는 중 빠른 요청 : 0.64초 (평소 0.63초, 1.0배)전혀 안 막힌다. 개발 서버는 요청이 올 때마다 스레드를 새로 만들어 주기
때문이다. 자리 수에 제한이 없으니 줄을 설 일도 없다.
주의
그래서 개발 서버로 성능을 재면 안 된다. 실제 배포는 워커 수가 정해져
있고, 그 제한이 곧 병목이 된다. 개발 환경에서 멀쩡하던 것이 배포하자마자
느려지는 흔한 이유다.
그럼 어떻게 하나#
떠오르는 방법들을 하나씩 따져 보자.
| 방법 | 되나? |
|---|---|
| 타임아웃을 1초로 줄인다 | 느린 사이트가 전부 실패한다. 8초 걸려도 성공했을 것들까지 |
| 워커를 늘린다 | 시간을 벌 뿐. 메모리만 더 쓴다 |
fetcher 파드를 늘린다 |
같은 이야기. 자리가 늘 뿐 |
| 기다리지 않게 한다 | ✅ |
마지막 것이 답이다. 지금 구조는 이렇다.
사용자 ─── 요청 ───▶ web ───▶ fetcher ───▶ 바깥 사이트
   ▲                                            │
   └──────────── 다 끝날 때까지 기다림 ──────────┘
사용자를 끝까지 붙잡아 두는 게 문제다. 요청을 받아 두고 "접수했습니다" 하고
바로 답한 뒤, 실제 작업은 뒤에서 하면 된다. 그러면 죽은 주소가 8초를 먹든
말든 사용자는 기다리지 않는다.
그 "받아 두는 곳" 이 메시지 큐다.
정리#
- 평균은 0.41초인데 최악은 8초다. 평균만 보면 멀쩡해 보이는 시스템이 꼬리 지연 때문에 무너진다. 응답시간은 p95·p99 로 봐야 한다.
- 자리 수가 정해져 있으면 남의 느린 요청이 내 빠른 요청을 막는다. 실측으로 34배, 최악 74배까지 늘어났다.
- 개발 서버로 재면 이 문제가 안 보인다. 요청마다 스레드를 만들어 주기 때문이다. 성능은 실제 배포 구성으로 재야 한다.
- 워커를 늘리는 건 해결이 아니라 지연이다. 근본 해결은 사용자를 기다리게 하지 않는 것 — 다음 편에서 RabbitMQ 를 넣는다.

댓글