앞 편에서 문제를 찾았다. 죽은 주소 두 개가 서버 자리를
붙잡으면, 0.2초면 끝날 멀쩡한 요청이 7.17초를 기다렸다.
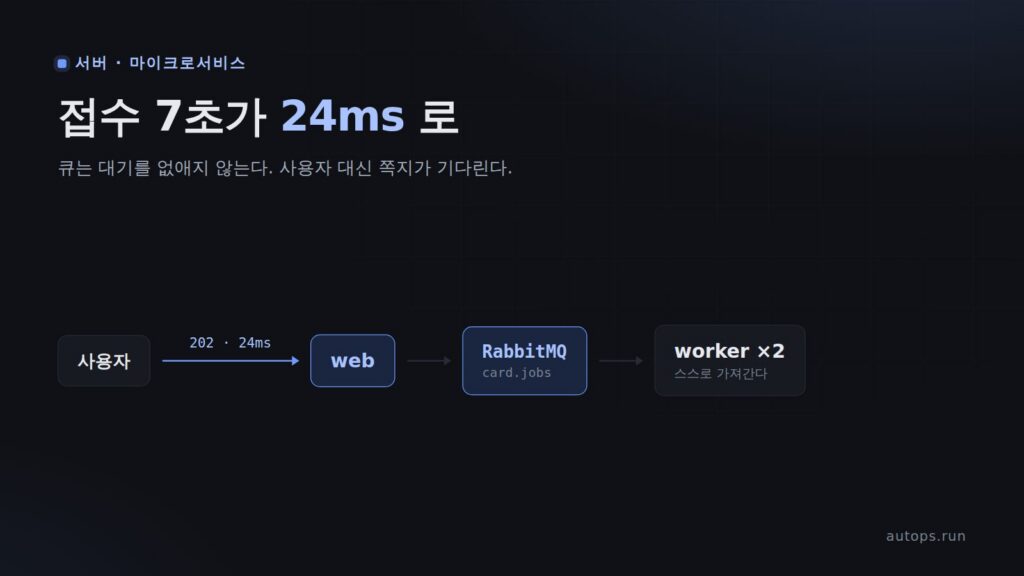
원인은 사용자를 작업이 끝날 때까지 붙잡아 두는 구조였다. 이번 편에서는 요청을
받자마자 "접수했어요" 하고 돌려보내고, 실제 작업은 뒤에서 하게 바꾼다.
무엇이 바뀌나#
[앞 편] 사용자 ──▶ web ──▶ fetcher ──▶ 바깥 사이트
          ▲                                  │
          └────── 다 끝날 때까지 기다림 ─────┘

[이번]  사용자 ──▶ web ──▶ RabbitMQ ──▶ worker ──▶ 바깥 사이트
          ▲         │                      │
└─ 즉시 ──┘ └──▶ Redis (결과)| 전 | 후 | |
|---|---|---|
web 이 하는 일 |
fetcher 를 부르고 기다린다 | 큐에 넣고 바로 답한다 |
| 작업하는 쪽 | fetcher (요청을 받는다) | worker (스스로 가져간다) |
| 결과는 | 응답에 바로 담긴다 | Redis 에 두고, 화면이 물어본다 |
먼저 용어 셋#
처음 보는 분을 위해 짚는다.
- 메시지 큐 — 일을 적어 둔 쪽지를 쌓아 두는 곳. 넣는 쪽과 꺼내는 쪽이 서로를 몰라도 된다.
- 생산자(publisher) — 쪽지를 넣는 쪽. 여기선
web. - 소비자(consumer) — 쪽지를 꺼내 처리하는 쪽. 여기선
worker.
참고
식당으로 비유하면. 앞 편의 구조는 손님이 주방 앞에 서서 요리가 나올 때까지
기다리는 것이었다. 큐는 주문서 꽂이다. 손님은 주문만 하고 자리에 앉는다.
요리사는 꽂이에서 주문서를 하나씩 뽑아 간다. 요리사가 몇 명이든 손님은 신경 쓸 필요가 없다.
1. RabbitMQ 를 올린다 — StatefulSet 으로#
큐에 쌓인 쪽지는 디스크에 남아야 한다. RabbitMQ 가 재시작되면 쌓여 있던 작업이
통째로 사라지면 곤란하다. 그래서 Deployment 가 아니라 StatefulSet + PVC 로 올린다.
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: rabbitmq
  namespace: linkcard
spec:
  serviceName: rabbitmq
  replicas: 1
  selector:
    matchLabels: { app: rabbitmq }
  template:
    metadata:
      labels: { app: rabbitmq }
    spec:
      containers:
        - name: rabbitmq
          image: rabbitmq:4-management
          env:
            - { name: RABBITMQ_DEFAULT_USER, value: "linkcard" }
            - { name: RABBITMQ_DEFAULT_PASS, value: "linkcard-dev" }
          volumeMounts:
            - name: data
              mountPath: /var/lib/rabbitmq      # 여기에 큐가 저장된다
  volumeClaimTemplates:
    - metadata: { name: data }
      spec:
        accessModes: [ReadWriteOnce]
        resources:
          requests:
storage: 1Gi참고
왜 StatefulSet 이어야 하는지는
파드가 죽으면 데이터도 사라진다 — StatefulSet 과 PVC 로 남기는 법에
자세히 정리했다. 요점은 재시작해도 같은 이름으로 돌아와 같은 저장소를 다시 문다는 것이다.
주의
비밀번호를 YAML 에 그대로 적었다. 실습이라서다. 실제로는 Secret 으로 빼야 하고,
git 에 올리는 저장소라면 더더욱 그렇다.
2. web — 넣고, 바로 답한다#
def _publish(job_id, url):
    conn = pika.BlockingConnection(pika.URLParameters(RABBIT_URL))
    try:
        ch = conn.channel()
        ch.queue_declare(queue="card.jobs", durable=True)   # ①
        ch.basic_publish(
            exchange="", routing_key="card.jobs",
            body=json.dumps({"job_id": job_id, "url": url}),
            properties=pika.BasicProperties(delivery_mode=2),  # ②
        )
    finally:
        conn.close()


@app.post("/api/cards")
def create_card():
    url = request.json["url"]
    job_id = uuid.uuid4().hex[:12]
    _publish(job_id, url)
    _save(job_id, {"status": "queued", "url": url, "queued_at": time.time()})
    return jsonify(ok=True, job_id=job_id, status="queued"), 202     # ③
세 군데를 짚는다.
① durable=True — 큐 자체를 디스크에 남긴다. RabbitMQ 가 재시작돼도 큐가 사라지지 않는다.
② delivery_mode=2 — 메시지도 디스크에 남긴다. ①만 하고 이걸 빼면 큐는 살아남는데
안의 쪽지는 사라진다. 둘 다 켜야 한다.
③ 202 — HTTP 상태 코드다. 200 OK 가 "끝났다" 라면 202 Accepted 는
"받았고, 아직 안 끝났다" 는 뜻이다. 비동기 작업에 딱 맞는 코드다.
3. worker — 스스로 가져간다#
def handle(ch, method, props, body):
    job = json.loads(body)
    result = build_card(job["url"])      # 여기서 8초가 걸려도 아무도 안 기다린다
    report(job["job_id"], result)
    ch.basic_ack(method.delivery_tag)    # ④ "다 했다"


ch.queue_declare(queue="card.jobs", durable=True)
ch.basic_qos(prefetch_count=1)           # ⑤
ch.basic_consume(queue="card.jobs", on_message_callback=handle)
ch.start_consuming()
④ basic_ack — 처리가 끝난 뒤에 보낸다. 이걸 받아야 RabbitMQ 가 큐에서 지운다.
중간에 워커가 죽으면 ack 가 안 가니, RabbitMQ 가 그 쪽지를 다른 워커에게 다시 준다.
다음 편에서 이걸 제대로 다룬다.
⑤ prefetch_count=1 — 한 번에 하나씩만 가져간다. 이게 없으면 워커 하나가 쌓인
쪽지를 한꺼번에 쓸어 가서 다른 워커는 논다.
워커에는 Service 가 없다#
매니페스트를 보면 알 수 있다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: linkcard-worker
spec:
  replicas: 2
# ... Service 는 만들지 않았다2편에서는 서비스마다 Service 를 붙였다.
워커에는 필요 없다. 아무도 워커를 부르지 않기 때문이다. 워커가 스스로 큐에 붙어서
일을 가져간다. 동기 호출과 가장 다른 지점이다.
4. 재 본다#
앞 편과 같은 실험을 다시 했다.
=== 정상 흐름 ===
https://kubernetes.io/   접수 45ms → done  전체 0.58초
https://grafana.com/     접수 21ms → done  전체 0.78초

=== 죽은 주소 6개가 있어도 ===
접수 응답 : 24ms| 앞 편 (동기) | 이번 (큐) | |
|---|---|---|
| 죽은 주소가 섞였을 때 멀쩡한 요청의 응답 | 7,170ms | 24ms |
300배 빨라졌다. 죽은 주소가 몇 개가 들어오든 사용자는 24ms 만에 "접수됐어요" 를 받는다.
그런데 표에 없는 숫자가 하나 더 있다.
결과 도착 : done, 전체 23.64초5. 큐는 대기를 없애지 않았다. 옮겼다#
접수는 24ms 였지만 결과는 23.64초 뒤에 왔다. 워커 로그를 보면 이유가 보인다.
[worker] 시작 job=b82a16122bae url=http://10.255.255.1/
[worker] 완료 job=b82a16122bae ok=False elapsed=8.0s
[worker] 시작 job=586e094e5f13 url=https://www.docker.com/
[worker] 완료 job=586e094e5f13 ok=True elapsed=0.2s
워커 2개가 8초짜리 죽은 주소들을 처리하느라 바빴다. 멀쩡한 요청은 그 뒤에 줄을 섰다.
0.2초면 끝나는 일인데 차례가 오기까지 23초가 걸린 것이다.
주의
큐를 넣으면 빨라진다고 오해하기 쉽다. 전체 처리량은 그대로다. 달라진 건
누가 기다리느냐다. 전에는 사용자가 화면 앞에서 기다렸고, 지금은 쪽지가 큐에서 기다린다.그래도 이게 낫다. 사용자는 붙잡혀 있지 않고, 워커를 늘리면 줄이 줄어든다.
동기 구조에서는 워커를 늘려도 사용자가 계속 붙잡혀 있었다.
여기서 막혔다 — 세 번#
① 워커가 먼저 떠서 Name or service not known#
배포 직후 워커 로그다.
[worker] 연결 끊김, 5초 뒤 재시도: [Errno -2] Name or service not known
[worker] 연결 끊김, 5초 뒤 재시도: [Errno -2] Name or service not known
[worker] 대기 중 queue=card.jobs prefetch=1
워커가 RabbitMQ 보다 먼저 떴다. rabbitmq 라는 이름이 아직 풀리지 않았다.
재연결 루프를 넣어 둔 덕에 5초 뒤 알아서 붙었다.
팁
쿠버네티스는 기동 순서를 보장하지 않는다. 의존하는 서비스가 먼저 떠 있다고
가정하면 안 된다. 연결이 안 되면 죽지 말고 기다렸다가 다시 붙는 코드를 넣어 둔다.
② 결과 조회가 404#
카드를 만들면 "그런 작업이 없습니다" 가 떴다. 워커 로그에는 분명히 완료 가 찍혀 있었다.
처음엔 결과를 web 파드의 메모리에 들고 있었다.
_results = {} # 파드 메모리그런데 web 은 파드가 2개다. 요청 두 개가 서로 다른 파드로 갔다.
POST /api/cards   ──▶ web 파드 A   (여기 메모리에 저장)
GET  /api/cards/x ──▶ web 파드 B   (여기엔 없다 → 404)
파드를 여러 개 띄우려면 상태를 파드 밖에 둬야 한다. Redis 를 StatefulSet 으로
올리고 결과를 거기 넣었다.
_r = redis.Redis.from_url("redis://redis:6379/0")

def _save(job_id, data):
_r.setex(f"job:{job_id}", 3600, json.dumps(data)) # 1시간 뒤 자동 삭제주의
이 문제는 파드를 1개로 두고 개발하면 절대 안 보인다. 로컬에서 멀쩡하던 기능이
배포해서 파드를 늘리자마자 "가끔" 실패한다. 요청이 어느 파드로 가느냐에 따라
되기도 하고 안 되기도 해서, 원인 찾기가 고약한 종류다.
③ 조회 API 가 500#
Redis 로 옮기자마자 이번엔 500 이 났다.
TypeError: flask.json.jsonify() got multiple values for keyword argument 'ok'return jsonify(ok=True, **r)저장해 둔 결과 r 에 이미 ok 가 들어 있었다. 거기에 ok=True 를 또 넘기니 키가 겹쳤다.
return jsonify(r) 로 고쳤다.
확인#
kubectl get pods -n linkcardlinkcard-web-66878669c-7k9s8 1/1 Running
linkcard-web-66878669c-mc8gh 1/1 Running
linkcard-worker-6f4544d569-4ztxz 1/1 Running
linkcard-worker-6f4544d569-7bcvm 1/1 Running
rabbitmq-0 1/1 Running
redis-0 1/1 Running큐에 쪽지가 쌓여 있지 않고, 소비자가 2명 붙어 있는지 본다.
kubectl exec -n linkcard rabbitmq-0 -- rabbitmqctl list_queues name messages consumersname messages consumers
card.jobs 0 2정리#
- 큐는 사용자를 기다리게 하지 않는다. 죽은 주소가 섞여도 접수가 7,170ms 에서 24ms 로 줄었다. 응답은
202 Accepted로 준다. - 대신 대기가 사라진 게 아니라 옮겨졌다. 결과는 23.64초 뒤에 왔다. 전체 처리량은 그대로이고, 줄이려면 워커를 늘려야 한다.
durable큐와delivery_mode=2를 둘 다 켠다. 하나만 켜면 큐는 살아남아도 메시지가 사라진다.- 파드가 여럿이면 상태를 메모리에 두지 않는다. 접수한 파드와 조회하는 파드가 달라 404 가 난다.
- 기동 순서는 보장되지 않는다. 의존 서비스가 없으면 죽지 말고 재연결한다.
다음 편은 8초짜리 죽은 주소를 어떻게 처리할 것인가다. 지금은 실패하면 그냥 끝이다.
재시도할지, 몇 번까지 할지, 끝내 안 되면 어디로 보낼지 정한다.

댓글